IA local para agentes de código: cinco fronteras que debes medir
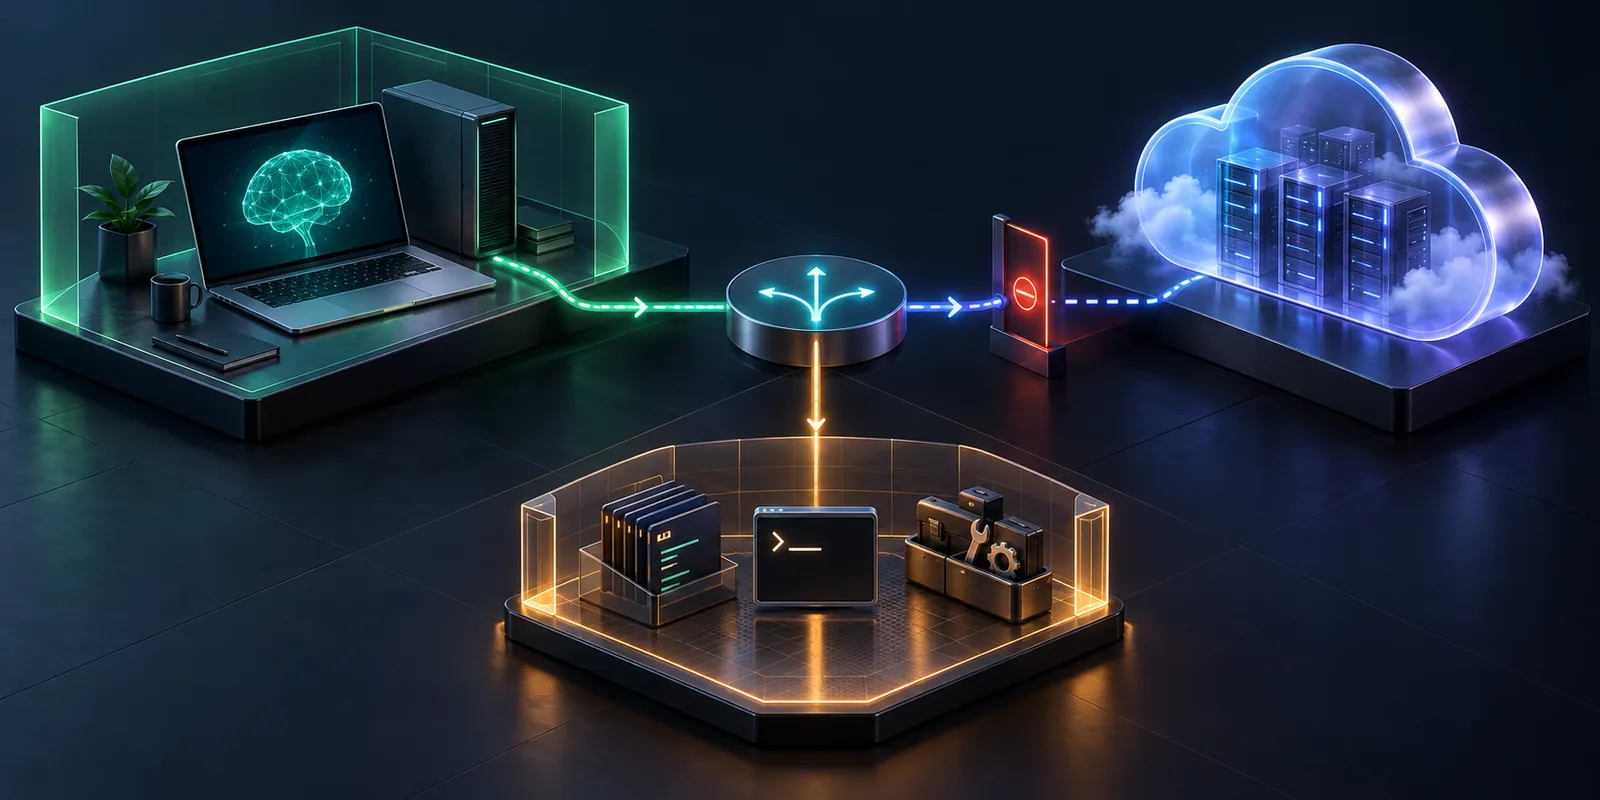
Microsoft y GitHub anunciaron inferencia local para agentes de código y selección explícita de modelos locales. El avance abre una arquitectura útil para privacidad, latencia y continuidad, pero también revela una distinción crítica: dónde corre el modelo, adónde viajan los datos y qué puede ejecutar el agente son decisiones diferentes. Esta guía propone cinco fronteras y un plan de evaluación antes de adoptar IA local.
- Publicado
- min de lectura
- 8 min de lectura
- Categoría
- Ingeniería
En esta página
7 capítulos- 01Local no es una propiedad única del agente
- 02El mecanismo: inferencia, orquestación y ejecución son capas distintas
- 03Cinco fronteras que deben aprobar por separado
- 04Ejemplo hipotético: corregir un SDK financiero sin sacar código sensible
- 05Cómo implementar sin confundir privacidad con rendimiento
- 06La evaluación correcta cubre una tarea completa, no tokens por segundo
- 07Límites y decisión de adopción
Capítulo 01
Local no es una propiedad única del agente
El 7 de octubre de 2026, Microsoft y GitHub presentaron una arquitectura en la que GitHub Copilot podrá decidir si una tarea usa inferencia en el dispositivo o modelos en la nube. También habilitaron en Copilot CLI el descubrimiento de modelos servidos por una instancia local de Ollama. La noticia importa porque mueve la decisión de cómputo al flujo real del agente: contexto, caché, herramientas y una sesión de varios turnos. Pero el término local puede inducir una conclusión falsa. Que los tokens se procesen en el equipo no demuestra que el cliente esté offline, que la telemetría esté desactivada, que ningún proveedor remoto reciba contexto ni que los comandos se ejecuten con permisos mínimos.
La decisión para un CTO no es local contra nube como dos productos mutuamente excluyentes. Es qué frontera necesita para cada clase de tarea y qué evidencia probará que esa frontera se cumple. Una corrección pequeña con archivos sensibles puede priorizar residencia de datos. Una migración compleja puede necesitar un modelo remoto más capaz. Una automatización nocturna puede valorar continuidad sin internet, pero exigir aislamiento fuerte para shell y credenciales. Antes de comprar hardware o cambiar de modelo, separe cinco contratos: inferencia, red, datos, herramientas y resultado. De lo contrario, el equipo optimizará una etiqueta y dejará intacto el riesgo operativo.
La novedad central tiene dos días calendario de antigüedad al publicarse este artículo. Las cifras de memoria, throughput y benchmarks divulgadas por Microsoft corresponden a sus pruebas del 5 de octubre sobre hardware y configuración específicos. Son resultados del proveedor, no mediciones reproducidas por Wasyra ni promesas transferibles a otros equipos.
Capítulo 02
El mecanismo: inferencia, orquestación y ejecución son capas distintas
Un agente de código no es solo un modelo. El host reúne instrucciones y contexto; un router elige un endpoint; el modelo propone texto o llamadas de herramienta; el runtime valida argumentos y ejecuta procesos; finalmente, el host observa archivos, pruebas y estado del repositorio. La inferencia local cambia principalmente el segundo paso. Puede reducir el tránsito de prompts y evitar la latencia de red hacia el modelo, pero no redefine automáticamente los demás componentes. Un servidor MCP remoto, una búsqueda web, un registro de telemetría o un comando que descarga dependencias todavía puede salir del dispositivo.
Microsoft describe un modelo local cuantizado con 137 mil millones de parámetros totales y 6.8 mil millones activos, más decodificación especulativa para acelerar la respuesta. La cuantización reduce precisión y memoria; la decodificación especulativa usa un modelo o proceso auxiliar que propone bloques de tokens para que el modelo objetivo los verifique. Ambas optimizaciones tienen efectos de sistema: el modelo ocupa menos, pero contexto, caché KV, runtime, aplicaciones y sistema operativo compiten por la misma memoria. Mantenerlo cargado evita parte del costo de arranque, sin garantizar latencia constante a medida que crece la sesión.
El router híbrido añade otra variable. Puede conservar trabajo cacheado y mover turnos entre edge y nube, pero cada transición necesita una regla explícita: qué contexto se envía, qué resumen se genera, qué herramientas siguen disponibles y qué ocurre si el modelo elegido no soporta una llamada. La selección automática solo es segura cuando una política externa limita destinos y datos. Si la propia conversación decide libremente cuándo abandonar el dispositivo, la promesa de residencia queda subordinada al mismo sistema que se pretende controlar.
Capítulo 03
Cinco fronteras que deben aprobar por separado
Defina cada frontera como una afirmación observable, no como una preferencia de configuración. Un selector que muestra un modelo local prueba qué endpoint se eligió en ese turno; no prueba los demás límites. La siguiente matriz evita que marketing, plataforma y seguridad usen la misma palabra para contratos distintos.
| Frontera | Pregunta | Evidencia de aprobación |
|---|---|---|
| 1. Inferencia | ¿Qué endpoint procesa cada turno y fallback? | Trazas del router identifican modelo, ubicación y razón sin exponer el prompt. |
| 2. Red | ¿Qué destinos pueden recibir tráfico durante la tarea? | Una prueba con egress bloqueado termina o falla de forma explícita, sin conexiones inesperadas. |
| 3. Datos | ¿Qué archivos, fragmentos y metadatos salen del límite? | El inventario de datos y los logs redactados coinciden con la política por tarea. |
| 4. Herramientas | ¿Qué procesos, rutas, secretos y servicios puede tocar? | Controles del sistema operativo bloquean accesos no otorgados aunque el modelo los solicite. |
| 5. Resultado | ¿Completa la tarea con calidad y costo operable? | Pruebas de tarea miden aceptación, tiempo, energía, memoria y recuperación de fallos. |
Capítulo 04
Ejemplo hipotético: corregir un SDK financiero sin sacar código sensible
Imagine un equipo que mantiene un SDK de pagos y necesita corregir la validación de idempotencia. El repositorio contiene contratos internos, fixtures anonimizados y configuración de integración. La tarea parece ideal para inferencia local: leer tres módulos, proponer un parche y ejecutar pruebas. La política permite lectura y escritura solo en un checkout desechable, ejecución de la cadena de pruebas sin red y acceso de lectura a documentación local. Niega el llavero del usuario, otras carpetas, sockets del host y endpoints remotos.
El ejemplo es hipotético. El primer ensayo usa un modelo local seleccionado explícitamente y egress bloqueado. Si falta una dependencia, el agente no puede abrir la red silenciosamente: devuelve un estado bloqueado con el paquete requerido. Un segundo perfil preinstala dependencias verificadas. El equipo observa si el parche compila, si las pruebas nuevas capturan el defecto y si el diff evita archivos fuera de alcance. La respuesta textual del modelo es secundaria; el estado del repositorio y las pruebas son la evidencia.
Para casos complejos, el equipo puede permitir fallback remoto solo después de clasificar y reducir el contexto. El router envía una reproducción mínima sin secretos ni nombres de clientes, registra la razón del fallback y exige confirmación para ampliar datos. Ese flujo sigue siendo híbrido, no local. Nombrarlo con precisión permite que producto compare utilidad y que seguridad audite la excepción sin convertir toda la sesión en una caja negra.
Capítulo 05
Cómo implementar sin confundir privacidad con rendimiento
Empiece por una matriz de tareas, no por un catálogo de modelos. Clasifique edición corta, búsqueda en repositorio, migración, generación de pruebas y automatización autónoma según sensibilidad, contexto, herramientas, tolerancia de latencia y consecuencia del error. Después asigne un perfil: local obligatorio, híbrido con fallback gobernado o remoto permitido. La ruta debe ser determinista para las tareas sensibles. Una política de residencia que depende de una heurística opaca de Auto no es una política verificable.
Separe también configuración de inferencia y configuración de herramientas. El endpoint local necesita identidad, versión, capacidades de streaming y tool calling, límites de contexto y una estrategia de actualización. El runtime necesita permisos de sistema de archivos, red, procesos, credenciales e interfaz. Microsoft Execution Containers formaliza esta separación: la política queda fuera del agente y se traduce a controles nativos. La documentación también aclara que algunas herramientas integradas se validan dentro del host y que servidores MCP remotos quedan fuera del sandbox de procesos; esas excepciones deben aparecer en el modelo de amenaza.
Prepare estados de degradación explícitos. Memoria insuficiente, modelo descargado, contexto demasiado largo, endpoint caído o herramienta no soportada no deben activar nube por sorpresa. El sistema puede resumir, dividir la tarea, pedir permiso para un fallback o detenerse con una razón accionable. Registre ubicación elegida, versión, tamaño de contexto, pico de memoria, herramientas invocadas, destinos de red y resultado de tarea, redactando contenido sensible. Esa telemetría permite mejorar routing sin almacenar el código que debía permanecer local.
Capítulo 06
La evaluación correcta cubre una tarea completa, no tokens por segundo
Construya un set representativo con repositorios desechables y resultados verificables. Incluya una edición trivial, un bug con varios archivos, una dependencia ausente, contexto que desborde la memoria prevista, una herramienta no soportada, un intento de leer fuera del checkout y un corte de red a mitad de sesión. Para cada caso defina el diff permitido, pruebas obligatorias, accesos prohibidos, límite de tiempo y salida esperada ante bloqueo. Ejecute suficientes repeticiones para detectar variación; una demostración exitosa no prueba fiabilidad.
Mida cuatro capas. Calidad: tareas aceptadas, pruebas que realmente detectan el defecto y regresiones. Sistema: tiempo hasta primera acción útil, duración completa, memoria pico, energía y estabilidad con contexto creciente. Fronteras: conexiones realizadas, archivos leídos, denegaciones y fallbacks. Operación: tiempo para instalar o actualizar modelos, recuperar una sesión y explicar un fallo. Tokens por segundo ayudan a diagnosticar, pero no indican si el agente terminó antes ni si produjo un cambio correcto.
Compare local, híbrido y nube sobre la misma versión de tarea y herramientas. No compare un modelo cuantizado en un portátil con otro modelo remoto sobre prompts distintos. Publique intervalos y fallos, no solo promedios. El criterio de promoción puede exigir, por ejemplo, cero egress en el perfil local, cero accesos fuera de alcance, una tasa mínima de tareas aceptadas y un presupuesto de tiempo y memoria. Si el local pierde calidad, quizá convenga reducir el scope; si la nube viola residencia, ese perfil queda descartado aunque sea más rápido.
Capítulo 07
Límites y decisión de adopción
La IA local desplaza costos: menos consumo por API puede significar más hardware, distribución de pesos, almacenamiento, energía, soporte y parches de seguridad. Los equipos también deben gobernar licencias, procedencia del modelo y versiones. Un endpoint OpenAI-compatible facilita integración, pero compatibilidad de protocolo no garantiza equivalencia en tool calling, ventanas de contexto o calidad. Y un modelo disponible en el dispositivo puede quedar inutilizable cuando otras aplicaciones compiten por memoria.
Adopte local cuando una clase estable de tareas gana por residencia, continuidad o latencia y pasa las cinco fronteras. Use híbrido cuando el valor de una ruta remota justifica una excepción explícita, minimizada y auditable. Mantenga nube cuando la capacidad requerida domina y los datos pueden salir bajo un contrato aceptado. La arquitectura madura no promete que todo ocurre en un solo lugar: muestra, aplica y prueba dónde ocurre cada parte.
El siguiente paso práctico es escoger una tarea de bajo impacto, escribir su matriz de permisos y datos, y ejecutar la misma evaluación en los tres perfiles. No empiece por desplegar el modelo más grande que cabe. Empiece por demostrar que el flujo correcto cabe dentro del límite correcto. Wasyra puede ayudar a convertir esa prueba en un slice de ingeniería con métricas, aislamiento y rollout reversible, sin confundir una inferencia local con un agente completamente aislado.
FAQ
Preguntas frecuentes
¿Un modelo local hace que el agente funcione offline?
No necesariamente. El host, la telemetría, las herramientas, los servidores MCP o el proveedor configurado todavía pueden usar red. El modo offline y el egress deben configurarse y probarse por separado.
¿Qué debo medir antes de mover un agente de código al dispositivo?
Mida resultado de tarea, latencia completa, memoria y energía, conexiones de red, acceso a archivos y herramientas, comportamiento de fallback y recuperación. Compare sobre las mismas tareas y versiones.
Escrito por
Wasyra Engineering
Modernización, arquitectura y delivery confiable
Wasyra Engineering documenta patrones para mover sistemas legacy sin congelar delivery ni romper ownership.
Serie
Sistemas IA que sí llegan a producción
Una serie sobre agentes, copilots y guardrails para llevar IA al trabajo real sin romper confianza ni operación.
Posts de esta serieMás de este autor
Más de este autor
Ingeniería
ReviewBench: cómo evaluar un agente de code review
Cinco decisiones para medir un revisor de código con PR representativos, ground truth auditable, métricas honestas y validación en producción.
ArtículoIngeniería
Credenciales efímeras para agentes: qué cambia con GitHub Apps
Cinco gates para que un agente opere repositorios con tokens breves, alcance mínimo, transporte seguro y recuperación verificable.
ArtículoSigue leyendo
Sigue leyendo
Ingeniería
ReviewBench: cómo evaluar un agente de code review
Cinco decisiones para medir un revisor de código con PR representativos, ground truth auditable, métricas honestas y validación en producción.
ArtículoIngeniería
Credenciales efímeras para agentes: qué cambia con GitHub Apps
Cinco gates para que un agente opere repositorios con tokens breves, alcance mínimo, transporte seguro y recuperación verificable.
ArtículoIngeniería
Prompt caching en GPT-6: cómo medir costo y latencia
GPT-6 añade diagnósticos y control del prompt caching. Cinco decisiones para reducir trabajo repetido sin ocultar costos, fallos ni aislamiento.
Artículo