IA física híbrida: qué inferencia dejar dentro del robot
Una guía para dividir control local y cómputo remoto, presupuestar latencia, diseñar degradación segura y evaluar robots por tareas completas.
- Publicado
- 24 de setiembre de 2026
- min de lectura
- 7 min de lectura
- Categoría
- Ingeniería
En esta página
9 capítulos- 01La pregunta no es edge o cloud, sino qué puede esperar
- 02Cómo funciona una arquitectura híbrida de inferencia
- 031. Clasifica cada bucle por consecuencia y plazo
- 042. Presupuesta la latencia de extremo a extremo
- 053. Diseña la desconexión antes del camino feliz
- 06Ejemplo hipotético: inspección de pallets en un almacén
- 074. Limita datos, 5. aísla capacidad compartida
- 086. Evalúa tareas cerradas, no una inferencia aislada
- 09La decisión: distribuir capacidad sin distribuir la seguridad
Capítulo 01
La pregunta no es edge o cloud, sino qué puede esperar
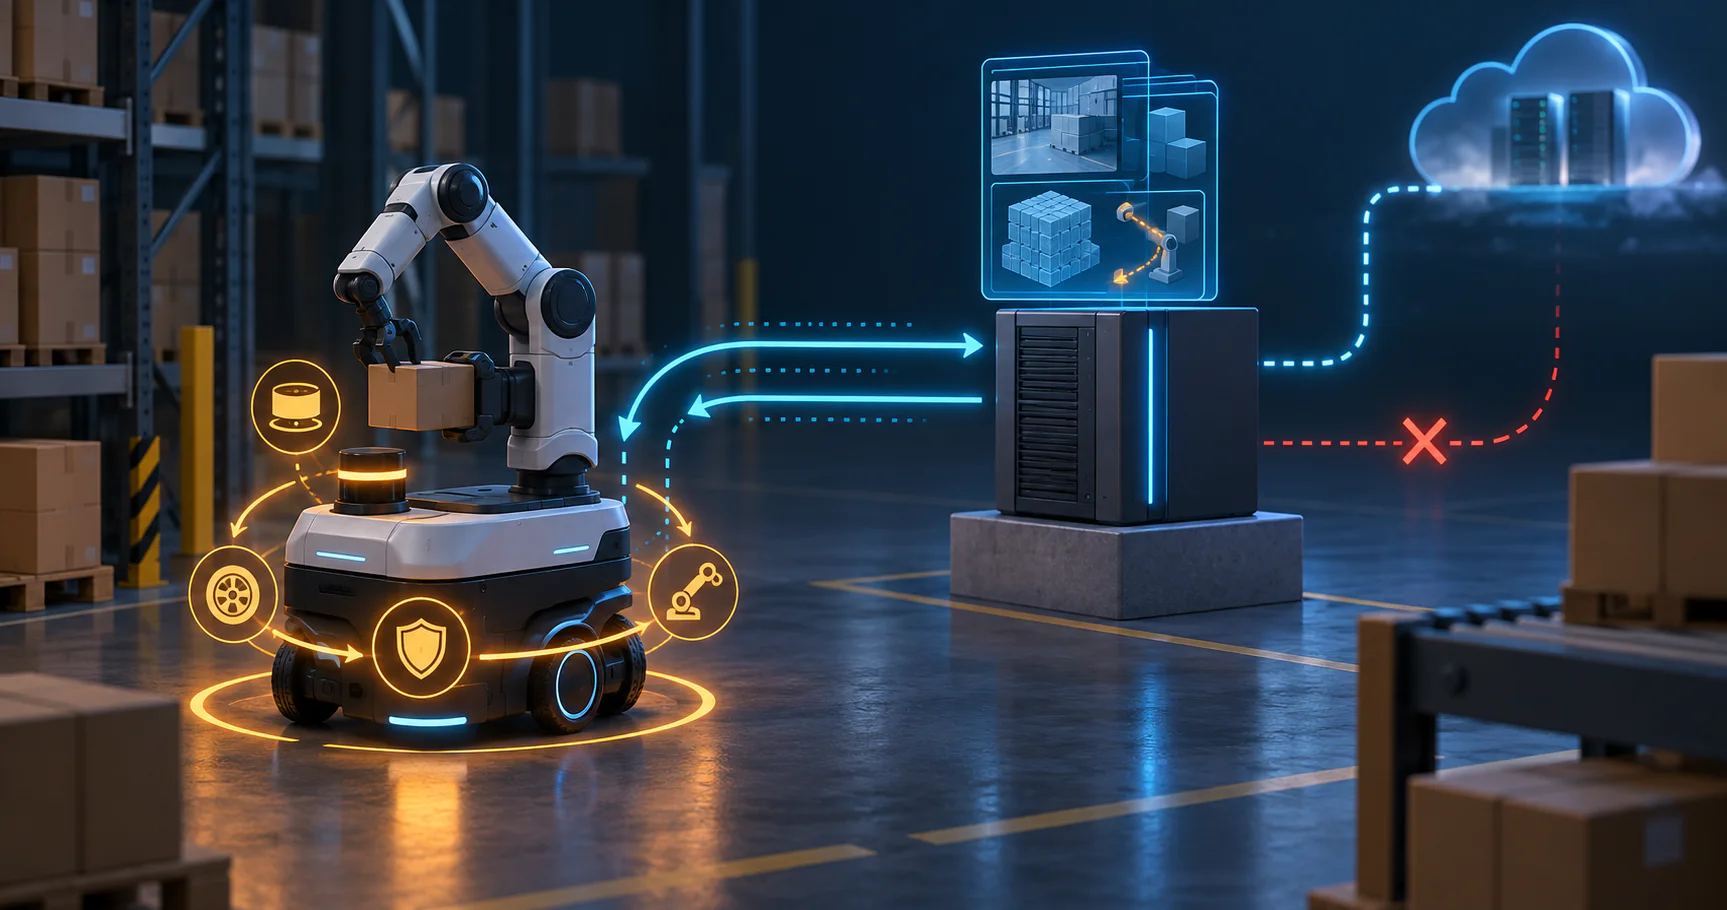
Un robot móvil necesita percibir, planificar y actuar dentro de límites físicos. Poner toda la inferencia en una GPU embarcada reduce la dependencia de la red, pero añade peso, consumo, calor y un techo de memoria. Enviar todo a un servidor permite modelos mayores, aunque convierte latencia, congestión y desconexiones en parte del comportamiento del robot. Ninguna ubicación es correcta por sí sola: la unidad de decisión debe ser cada bucle y su plazo máximo tolerable.
Microsoft Research publicó el 23 de septiembre de 2026 una herramienta de offload para su Physical AI Toolchain y presentó mediciones de manipulación móvil entre GPU embarcada, edge y cloud. El anuncio es nuevo; el informe técnico que sustenta las mediciones está fechado en marzo y se usa aquí como contexto, no como un resultado descubierto esta semana. Sus cifras describen el hardware, los modelos y la red evaluados por el equipo, no una garantía transferible a cualquier robot.
Capítulo 02
Cómo funciona una arquitectura híbrida de inferencia
La división útil conserva en el robot los controles deterministas y sensibles al tiempo: paro, límites de velocidad y fuerza, evitación inmediata, watchdogs y una política mínima de movimiento seguro. Percepción semántica, mapas globales, planificación de varios pasos o políticas que requieren una GPU mayor pueden ejecutarse en un servidor del mismo sitio. Cloud queda para trabajo menos urgente, capacidad elástica o coordinación que soporte una latencia más variable.
El mecanismo exige algo más que mover un contenedor. Cada solicitud debe llevar identidad del robot, versión de modelo, instante de captura, plazo de validez y un identificador idempotente. La respuesta necesita indicar para qué estado fue calculada. Si el robot ya cambió de posición, una acción técnicamente correcta puede estar vencida. El cliente debe descartar resultados tardíos y continuar con su política local, no ejecutar instrucciones en orden de llegada.
Capítulo 03
1. Clasifica cada bucle por consecuencia y plazo
Haz un inventario de decisiones, no solo de modelos. Para cada bucle registra frecuencia, peor latencia aceptable, volumen de entrada, memoria requerida y efecto de una respuesta errónea o ausente. Un detector que detiene el brazo ante una persona tiene una consecuencia distinta a un modelo que decide el siguiente estante. El primero debe funcionar localmente aun cuando el servidor, la red o la autenticación fallen; el segundo puede esperar, reintentarse o pedir intervención.
Trata la clasificación como un contrato de seguridad versionado. Una actualización que vuelve más pesada la percepción o cambia el tamaño del contexto no debe desplazar silenciosamente un bucle local hacia la red. Exige revisión cuando cambie el plazo, la consecuencia o la capacidad mínima. El resultado práctico es una tabla de colocación con razones explícitas: local obligatorio, edge preferido, cloud permitido o ejecución diferida.
Capítulo 04
2. Presupuesta la latencia de extremo a extremo
Medir solo el tiempo del modelo es insuficiente. El presupuesto incluye captura, compresión, cola, subida, deserialización, inferencia, retorno, validación y aplicación física. Registra percentiles altos y ráfagas, no únicamente promedios. El informe de Microsoft advierte que la latencia adicional puede degradar precisión de tarea y que el ancho de banda vuelve poco práctico un offload ingenuo a cloud. La red forma parte del modelo operativo aunque no aparezca en sus pesos.
Define un deadline por solicitud y cancela trabajo que ya no puede influir en la acción. Propaga ese plazo a la cola del servidor para no gastar GPU en resultados que el robot descartará. Separa además latencia de frescura: una respuesta rápida basada en una imagen vieja también es peligrosa. Observa edad del sensor al actuar, tasa de expiración, tiempo en cola y porcentaje de decisiones tomadas por fallback.
Capítulo 05
3. Diseña la desconexión antes del camino feliz
El fallback no debe ser una excepción improvisada. Define qué hace el robot cuando pierde una respuesta, acumula tres expiraciones o detecta que la versión remota no coincide con la esperada. Según el caso puede reducir velocidad, completar un movimiento acotado, detenerse en una zona segura o pedir asistencia. Nunca debería continuar indefinidamente con el último plan si el entorno cambia. El estado degradado necesita una señal visible y telemetría propia.
Prueba fallos deliberados: pérdida total, jitter, paquetes duplicados, servidor saturado, credencial expirada y reinicio durante una tarea. Verifica la transición y la recuperación, incluido el rechazo de respuestas que pertenecen a la sesión anterior. Un diseño aprobado no es el que nunca se desconecta en la demo, sino el que mantiene límites físicos cuando todos los componentes remotos dejan de ayudar.
Capítulo 06
Ejemplo hipotético: inspección de pallets en un almacén
Imagina un robot hipotético que recorre pasillos, fotografía pallets y marca daños. El control de ruedas, el paro de emergencia, la detección inmediata de personas y un mapa local corto permanecen embarcados. Un servidor edge dentro del almacén recibe imágenes seleccionadas, ejecuta detección visual más pesada y propone el siguiente punto de inspección. Cloud consolida reportes y entrena nuevas versiones fuera del bucle de movimiento.
Si el enlace edge supera el deadline, el robot no usa una detección tardía para girar. Reduce su velocidad, termina el tramo local ya validado y se detiene en el siguiente punto seguro. Guarda miniaturas y eventos con una política de retención, no video continuo por defecto. Cuando vuelve la red, reconcilia por identificador de tarea y descarta planes viejos. Este diseño conserva utilidad sin confundir cómputo remoto con autoridad física ilimitada.
Capítulo 07
4. Limita datos, 5. aísla capacidad compartida
Offload amplía la superficie de datos y control. Envía solo los sensores necesarios, cifra en tránsito, autentica robot y servicio mutuamente y separa telemetría de contenido sensible. Versiona schemas y modelos; firma artefactos; limita qué comandos acepta el cliente. Una respuesta remota debe describir una intención dentro de límites locales, no escribir directamente sobre actuadores. Revisa además residencia, retención y acceso humano a imágenes del entorno.
Una GPU edge compartida introduce competencia entre robots. Reserva capacidad para tareas con deadline, aplica colas por prioridad y evita que un robot ruidoso bloquee la flota. Mide admisiones rechazadas y diseña backpressure hacia el robot. El repositorio oficial usa Kubernetes para distribuir contenedores e incluye ejemplos de offload, pero adoptar el framework no sustituye el dimensionamiento, la segmentación de red ni los límites de cada sitio.
Capítulo 08
6. Evalúa tareas cerradas, no una inferencia aislada
Compara al menos tres configuraciones con la misma tarea y condiciones controladas: todo local, híbrida con edge y el modo degradado sin red. Mide éxito completo, intervenciones, casi colisiones, energía por tarea, edad de observación al actuar, bytes transferidos, ocupación de GPU y coste operativo. Segmenta por iluminación, congestión, distancia, carga del servidor y calidad del enlace. Un promedio global puede ocultar precisamente la cola donde falla la seguridad.
Usa las cifras publicadas como hipótesis de diseño, no como business case propio. El estudio reporta que algunos GPU pequeños no alojaron el stack completo y que la latencia y el ancho de banda pueden anular beneficios. Tu gate debe basarse en hardware, red y tarea reales. Promueve una versión solo si mejora el objetivo elegido sin empeorar límites de seguridad, y conserva rollback independiente para cliente, modelo y servicio remoto.
Capítulo 09
La decisión: distribuir capacidad sin distribuir la seguridad
La inferencia híbrida vale la pena cuando una GPU remota habilita una tarea que el robot no puede ejecutar con su presupuesto de energía, tamaño o memoria, y cuando esa tarea tolera un contrato de red explícito. No conviene si el equipo necesita conectividad perfecta para detenerse, no puede rechazar resultados vencidos o todavía desconoce el deadline del bucle. Primero separa autoridad, luego optimiza ubicación.
Para un piloto, empieza con un robot, una tarea repetible y seis decisiones documentadas: clasificación, latencia, degradación, datos, capacidad y evaluación. Si necesitas convertir esa matriz en una arquitectura y un plan de validación acotado, Wasyra puede ayudarte a diseñar el sistema y sus gates sin convertir una demostración en una promesa de producción.
Escrito por
Wasyra Engineering
Modernización, arquitectura y delivery confiable
Wasyra Engineering documenta patrones para mover sistemas legacy sin congelar delivery ni romper ownership.
Serie
Sistemas IA que sí llegan a producción
Una serie sobre agentes, copilots y guardrails para llevar IA al trabajo real sin romper confianza ni operación.
Posts de esta serieMás de este autor
Más de este autor
Ingeniería
Claude Opus 5.5: cómo migrar un agente sin romperlo
Claude Opus 5.5 cambia razonamiento, herramientas y progreso. Cinco gates para migrar agentes con evidencia, coste controlado y rollback.
ArtículoIngeniería
Grok 4.7: cómo conservar el razonamiento entre turnos
El lanzamiento de Grok 4.7 cambia el manejo del estado en Responses API. Cinco criterios para conservar contexto, evaluar continuidad y controlar riesgos.
ArtículoSigue leyendo
Sigue leyendo
Ingeniería
Claude Opus 5.5: cómo migrar un agente sin romperlo
Claude Opus 5.5 cambia razonamiento, herramientas y progreso. Cinco gates para migrar agentes con evidencia, coste controlado y rollback.
ArtículoIngeniería
Grok 4.7: cómo conservar el razonamiento entre turnos
El lanzamiento de Grok 4.7 cambia el manejo del estado en Responses API. Cinco criterios para conservar contexto, evaluar continuidad y controlar riesgos.
ArtículoIngeniería
Copilot Code Review: qué exigir cuando la IA ejecuta código
Copilot Code Review amplía sus herramientas de shell. Cinco criterios para verificar hallazgos, limitar accesos y evaluar revisiones con evidencia.
Artículo