ReviewBench: cómo evaluar un agente de code review
ReviewBench convierte la evaluación de agentes de code review en un sistema reproducible. Esta guía explica qué adoptar, qué no confundir con certeza y cómo conectar el benchmark offline con el trabajo real del equipo.
- Publicado
- min de lectura
- 9 min de lectura
- Categoría
- Ingeniería
En esta página
10 capítulos- 01Un agente que comenta mucho no necesariamente revisa bien
- 02El mecanismo: congelar el trabajo y evaluar hallazgos atómicos
- 03Decisión 1: representar tu carga, no la distribución más cómoda
- 04Decisión 2: construir ground truth desde fuentes que se contradicen
- 05Decisión 3: calibrar y versionar al juez automático
- 06Decisión 4: elegir el punto de operación, no un score mágico
- 07Ejemplo hipotético: evaluar antes de activar un merge gate
- 08Decisión 5: exigir correspondencia con producción
- 09Límites que deben quedar escritos
- 10La decisión no es comprar un score, sino construir confianza medible
Capítulo 01
Un agente que comenta mucho no necesariamente revisa bien
El demo de un agente de code review suele ser convincente: abre un pull request, señala una condición de carrera y propone un cambio. El problema aparece cuando hay que decidir si debe revisar todos los repositorios, bloquear merges o reemplazar parte del trabajo humano. Contar comentarios favorece al sistema más verboso; contar bugs conocidos ignora hallazgos nuevos; preguntar si el comentario suena razonable premia redacción, no utilidad. Sin un contrato de evaluación, cada mejora del prompt puede mover una métrica y empeorar la experiencia real.
GitHub publicó ReviewBench el 5 de octubre de 2026 como research preview abierto para comparar revisores sobre pull requests reales. El aporte importante no es un ranking aislado. Es una cadena auditable entre corpus, hallazgos, criterio de verdad, matcher, juez y métricas, más una comprobación separada contra experimentos online. Para un CTO, la pregunta útil no es quién ocupa hoy el primer puesto, sino qué partes de esa cadena debe reproducir antes de convertir un agente en control de calidad.
Capítulo 02
El mecanismo: congelar el trabajo y evaluar hallazgos atómicos
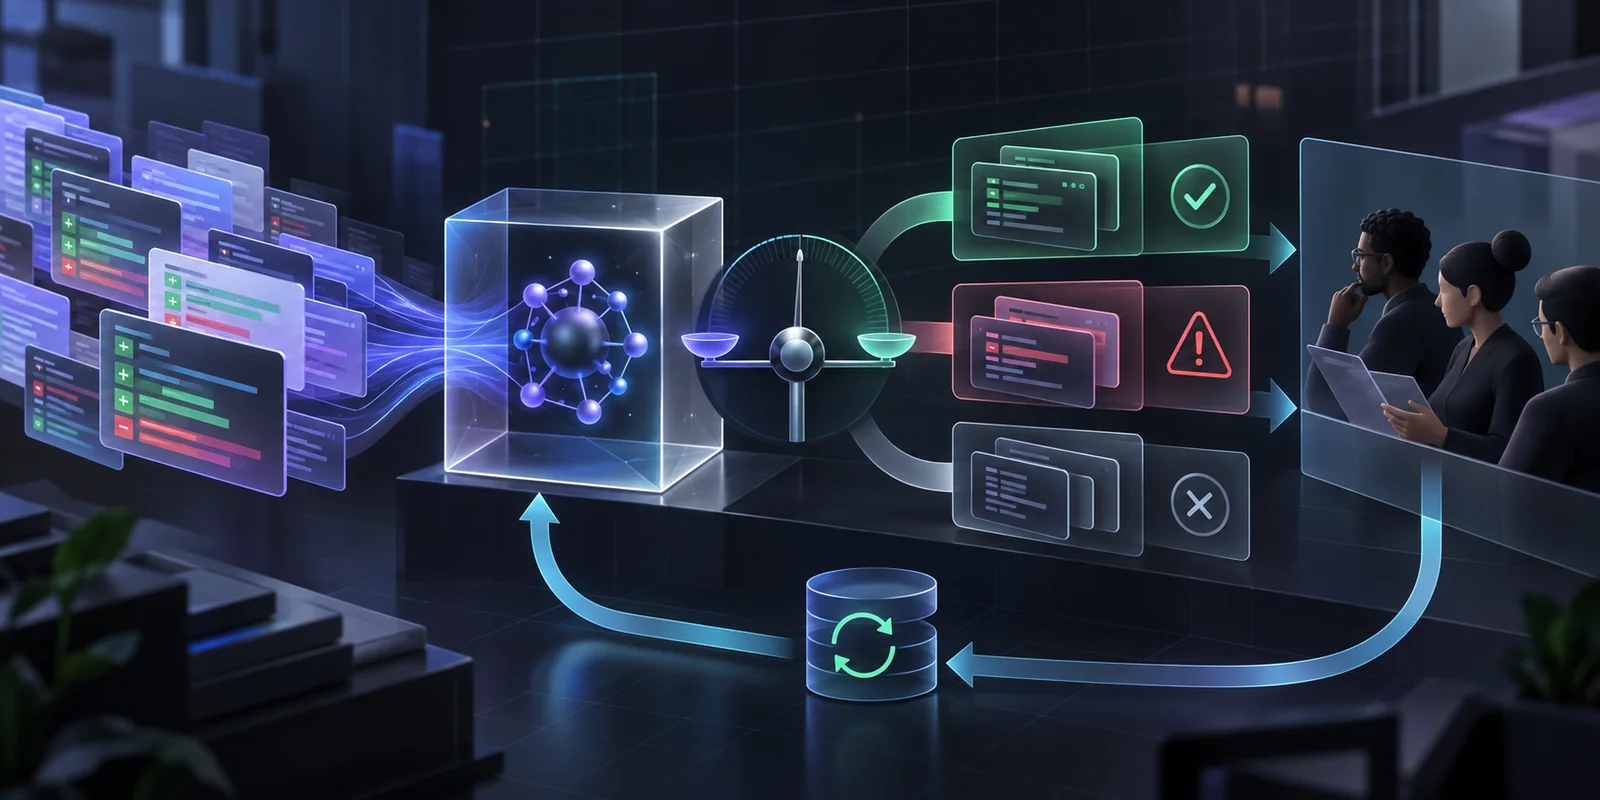
ReviewBench fija el commit base y el commit head de cada PR en el estado previo a las correcciones posteriores. El agente recibe ese cambio estable y produce hallazgos con archivo, rango de líneas y mensaje. Esa unidad atómica importa: una revisión extensa puede contener una observación correcta y tres afirmaciones imposibles de verificar. Puntuar el comentario completo ocultaría la mezcla; separar hallazgos permite identificar qué coincidió con un problema conocido, qué fue ruido y qué merece una evaluación nueva.
Después, un matcher semántico decide si el hallazgo candidato describe el mismo problema que uno del golden set, aunque use otra redacción o apunte a líneas cercanas. Los hallazgos sin match no se descartan automáticamente: pasan por el mismo criterio usado para etiquetar el corpus. Así el benchmark evita dos atajos frecuentes, el matching literal que pierde equivalencias válidas y el golden set cerrado que castiga a un agente precisamente por descubrir algo nuevo.
Capítulo 03
Decisión 1: representar tu carga, no la distribución más cómoda
El corpus público reúne 219 PR de 187 repositorios y 19 lenguajes. GitHub modeló lenguaje y tamaño de repositorio a partir de 103,9 millones de pull requests, pero hizo explícita una desviación: dio más peso a cambios medianos y grandes para no llenar el benchmark con ediciones triviales de un archivo. Esa transparencia es más valiosa que fingir una muestra perfectamente natural. Un benchmark debe documentar qué población intenta representar y qué sesgo deliberado introduce para hacer visible el trabajo difícil.
Tu empresa necesita además un slice privado. Separa por lenguaje, criticidad, tipo de cambio, tamaño, arquitectura y contexto requerido. Un revisor que funciona en refactors de TypeScript puede fallar en migraciones SQL o en permisos móviles. Conserva un set de desarrollo para ajustar prompts y un holdout que el equipo no use para iterar. Si cada error del holdout termina convertido inmediatamente en ejemplo del prompt, dejas de medir generalización y comienzas a memorizar tu examen.
Capítulo 04
Decisión 2: construir ground truth desde fuentes que se contradicen
Ningún revisor conoce todos los problemas de un cambio. ReviewBench combina comentarios humanos, correcciones posteriores del autor, herramientas deterministas y varios revisores basados en modelos. Luego deduplica observaciones equivalentes y juzga cada una con una rúbrica común. La fuente propone candidatos, pero no decide la verdad: un linter puede equivocarse, un humano puede priorizar estilo y un modelo puede formular con seguridad una premisa falsa.
Para un benchmark interno, define un verdadero positivo como una observación correcta, verificable, relevante y accionable según la barra real del repositorio. Registra también severidad, categoría, scope y contexto necesario. No borres desacuerdos: una discusión entre correctness y reliability puede ser informativa aunque ambos revisores acepten que existe el problema. Mantén evidencia del código y de la decisión humana, porque el golden set es una versión revisable del criterio del equipo, no una verdad natural e inmutable.
Capítulo 05
Decisión 3: calibrar y versionar al juez automático
El benchmark usa un clasificador basado en Claude Sonnet 5 para etiquetar hallazgos y un proceso humano para auditarlo. GitHub reporta 96,6% de acuerdo en true positive versus false positive después de revisión independiente; ese número describe acuerdo sobre ese corpus, no precisión universal ni reemplazo de ingenieros. La propia metodología documenta desacuerdos mucho mayores en severidad exacta y categoría, recordatorio de que una salida estructurada no elimina la ambigüedad.
Versiona prompt, modelo, umbrales, matcher, corpus y rúbrica como una sola configuración. Cuando cambie el juez, vuelve a calcular etiquetas y métricas afectadas, y conserva una muestra humana estratificada para detectar drift. Incluye casos donde existe una mitigación fuera del diff, comentarios duplicados y recomendaciones plausibles pero degradantes. Si el mismo modelo genera la revisión y decide si fue buena, añade revisión independiente: compartir puntos ciegos puede inflar una mejora sin que el sistema haya aprendido a revisar mejor.
Capítulo 06
Decisión 4: elegir el punto de operación, no un score mágico
Precision responde cuánto ruido introduce el agente; recall, cuántos problemas conocidos recupera. Un equipo que usa comentarios como sugerencias puede aceptar más cobertura. Un gate automático necesita precisión alta, especialmente en severidad crítica, porque un falso positivo repetido detiene delivery y erosiona confianza. F1 solo fija el mismo peso para ambas. Fβ permite hacer explícita otra preferencia, pero ninguna combinación decide por ti cuánto cuesta una omisión frente a una interrupción innecesaria.
Lee además por categoría y severidad. El promedio puede ocultar que el agente captura estilo y tests simples mientras omite seguridad o concurrencia. ReviewBench separa métricas grounded, comparables contra el golden set, de métricas augmented que reconocen hallazgos nuevos mediante el juez. La metodología advierte que augmented recall depende de los propios descubrimientos del agente y no debe ser el único ranking entre sistemas. Mantén también duración, costo por PR, volumen de comentarios y tasa de duplicados para observar la experiencia completa.
Capítulo 07
Ejemplo hipotético: evaluar antes de activar un merge gate
Supongamos una fintech con servicios Kotlin, un frontend TypeScript y una app Swift. El equipo selecciona 120 PR históricos, congela los commits previos a la revisión y construye hallazgos desde comentarios humanos, fixes posteriores, análisis estático e incidentes relacionados. Ingenieros senior adjudican una muestra, documentan el umbral de acción y reservan 30 PR como holdout. El ejemplo es hipotético: no representa un cliente ni un resultado de Wasyra.
Primero ejecuta el agente en modo silencioso y calcula precision y recall por stack, categoría y severidad. Si mejora el promedio pero duplica falsos positivos de seguridad en Swift, no lo promueve globalmente: ajusta retrieval y políticas en el set de desarrollo, vuelve a correr el holdout una sola vez por candidato serio y compara también costo y latencia. Después lo habilita como comentario no bloqueante en una fracción de repositorios y registra si el autor corrige, descarta, silencia o duplica el hallazgo.
Solo una clase estrecha de hallazgos pasa a gate: por ejemplo, secretos confirmados por herramienta determinista y validados por política. El resto sigue en suggestion mode mientras el equipo compara señal offline con acción online. Rollback significa poder volver a la configuración anterior del agente y del juez, no solo apagar un modelo. Esa separación evita convertir una mejora estadística en autoridad operativa antes de demostrar que ayuda a los desarrolladores.
Capítulo 08
Decisión 5: exigir correspondencia con producción
GitHub afirma que los movimientos offline de ReviewBench anticiparon la dirección de experimentos A/B de Copilot code review y publica un ejemplo con cambios en addressed rate, recall, volumen y costo. Son resultados del proveedor sobre su producto, no un efecto garantizado para otro agente. La lección transferible es el diseño de validación: definir antes qué señal online corresponde a cada métrica offline y comprobar dirección, magnitud, segmentos y efectos secundarios.
No conviertas addressed rate en verdad automática: un autor puede aplicar una sugerencia incorrecta, ignorar una correcta por falta de tiempo o aceptar un cambio cosmético. Combina conducta con muestreo humano, defectos escapados, tiempo hasta resolución, reversiones y percepción de ruido. Establece un stop condition si aumenta el volumen sin mejorar hallazgos críticos o si un repositorio sensible se desvía. El benchmark reduce incertidumbre antes del rollout; la producción decide si el sistema merece permanecer.
Capítulo 09
Límites que deben quedar escritos
ReviewBench es una research preview con proyectos públicos. Sus resultados pueden no representar código privado, monorepositorios, reglas internas, idiomas minoritarios o cambios que requieren ejecutar infraestructura. El corpus deliberadamente repondera tamaños de PR, el golden set puede estar incompleto y el juez comparte supuestos con los modelos evaluados. Además, un leaderboard cambia cuando cambian productos, configuraciones, modelos o el propio benchmark. Registra la fecha, versión y configuración exacta de cada comparación.
Tampoco confundas evaluación con permisos. Un agente que detecta bien un bug no adquiere por eso derecho a editar la rama, aprobar el PR o bloquear un release. Mantén separadas calidad de hallazgos, autoridad de ejecución y evidencia de que la corrección pasó tests y revisión. Esa frontera conserva el valor del benchmark sin convertirlo en una certificación de seguridad que nunca prometió ser.
Capítulo 10
La decisión no es comprar un score, sino construir confianza medible
Un benchmark útil para code review necesita cinco decisiones conectadas: corpus representativo, ground truth plural, juez calibrado y versionado, métricas alineadas al punto de operación y validación online. ReviewBench ofrece una referencia abierta para diseñarlas y también expone sus límites. Úsalo como punto de partida reproducible, añade tu carga privada y exige que cada mejora conserve su evidencia.
Si tu equipo está evaluando un agente de ingeniería, el siguiente paso no es activar el merge gate. Es definir qué cambios representa, qué hallazgo merece acción, quién audita al juez y qué señal de producción confirmará valor. Wasyra puede ayudar a convertir ese contrato en un piloto medible, con permisos graduales y rollback explícito, sin mezclar un buen demo con un sistema listo para operar.
FAQ
Preguntas frecuentes
¿Un benchmark público basta para elegir un agente de code review?
No. Sirve como comparación reproducible, pero debe complementarse con PR privados representativos, una barra de revisión propia y validación online antes de otorgar autoridad operativa.
¿Qué métrica importa más: precision o recall?
Depende del punto de operación. Un gate automático prioriza precision para no bloquear por ruido; un modo de sugerencias puede aceptar menor precision a cambio de más cobertura. Siempre conviene segmentar por severidad y categoría.
Escrito por
Wasyra Engineering
Modernización, arquitectura y delivery confiable
Wasyra Engineering documenta patrones para mover sistemas legacy sin congelar delivery ni romper ownership.
Serie
Sistemas IA que sí llegan a producción
Una serie sobre agentes, copilots y guardrails para llevar IA al trabajo real sin romper confianza ni operación.
Posts de esta serieMás de este autor
Más de este autor
Ingeniería
Credenciales efímeras para agentes: qué cambia con GitHub Apps
Cinco gates para que un agente opere repositorios con tokens breves, alcance mínimo, transporte seguro y recuperación verificable.
ArtículoIngeniería
Prompt caching en GPT-6: cómo medir costo y latencia
GPT-6 añade diagnósticos y control del prompt caching. Cinco decisiones para reducir trabajo repetido sin ocultar costos, fallos ni aislamiento.
ArtículoSigue leyendo
Sigue leyendo
Ingeniería
Credenciales efímeras para agentes: qué cambia con GitHub Apps
Cinco gates para que un agente opere repositorios con tokens breves, alcance mínimo, transporte seguro y recuperación verificable.
ArtículoIngeniería
Prompt caching en GPT-6: cómo medir costo y latencia
GPT-6 añade diagnósticos y control del prompt caching. Cinco decisiones para reducir trabajo repetido sin ocultar costos, fallos ni aislamiento.
ArtículoIngeniería
IA física híbrida: qué inferencia dejar dentro del robot
Microsoft propone descargar inferencia robótica a edge o cloud. Seis decisiones para ganar capacidad sin entregar seguridad a la red.
Artículo