Prompt caching en GPT-6: cómo medir costo y latencia
Una guía para diseñar prefijos reutilizables, calcular escrituras y lecturas, evolucionar herramientas y evaluar el ahorro por tarea aceptada.
- Publicado
- 25 de setiembre de 2026
- min de lectura
- 7 min de lectura
- Categoría
- Ingeniería
En esta página
9 capítulos- 01El costo de un agente largo no está solo en la respuesta
- 02Qué reutiliza el caché y qué debe volver a calcular
- 031. Diseña el prefijo como un contrato versionado
- 042. Calcula la economía por cohorte y tarea aceptada
- 053. Cambia capacidad sin reescribir el pasado
- 06Ejemplo hipotético: un agente de soporte con tres ramas
- 074. Aísla cuentas, regiones y datos sensibles
- 085. Trata los misses y la expiración como caminos normales
- 09La decisión es comprar reutilización demostrada
Capítulo 01
El costo de un agente largo no está solo en la respuesta
Un agente que trabaja durante horas vuelve a enviar instrucciones, definiciones de herramientas, historial y material de referencia. Aunque el nuevo turno sea corto, procesar otra vez ese prefijo puede dominar el tiempo hasta el primer token y el costo de entrada. El problema crece cuando varias ramas parten de una misma conversación o cuando un equipo incorpora documentos extensos a cada solicitud. Optimizar solo el número de tokens de salida deja fuera una parte importante de la economía real.
OpenAI publicó el 22 de septiembre de 2026 mejoras de prompt caching para GPT-6: una ventana elegible de 30 minutos, un panel, diagnósticos de misses, breakpoints explícitos y prewarming. Este artículo, publicado tres días calendario después en Lima, analiza ese mecanismo. No ejecutamos GPT-6 ni reproducimos las cifras de clientes citadas en el anuncio; las tratamos como reportes del proveedor, no como resultados que otra aplicación pueda asumir.
Capítulo 02
Qué reutiliza el caché y qué debe volver a calcular
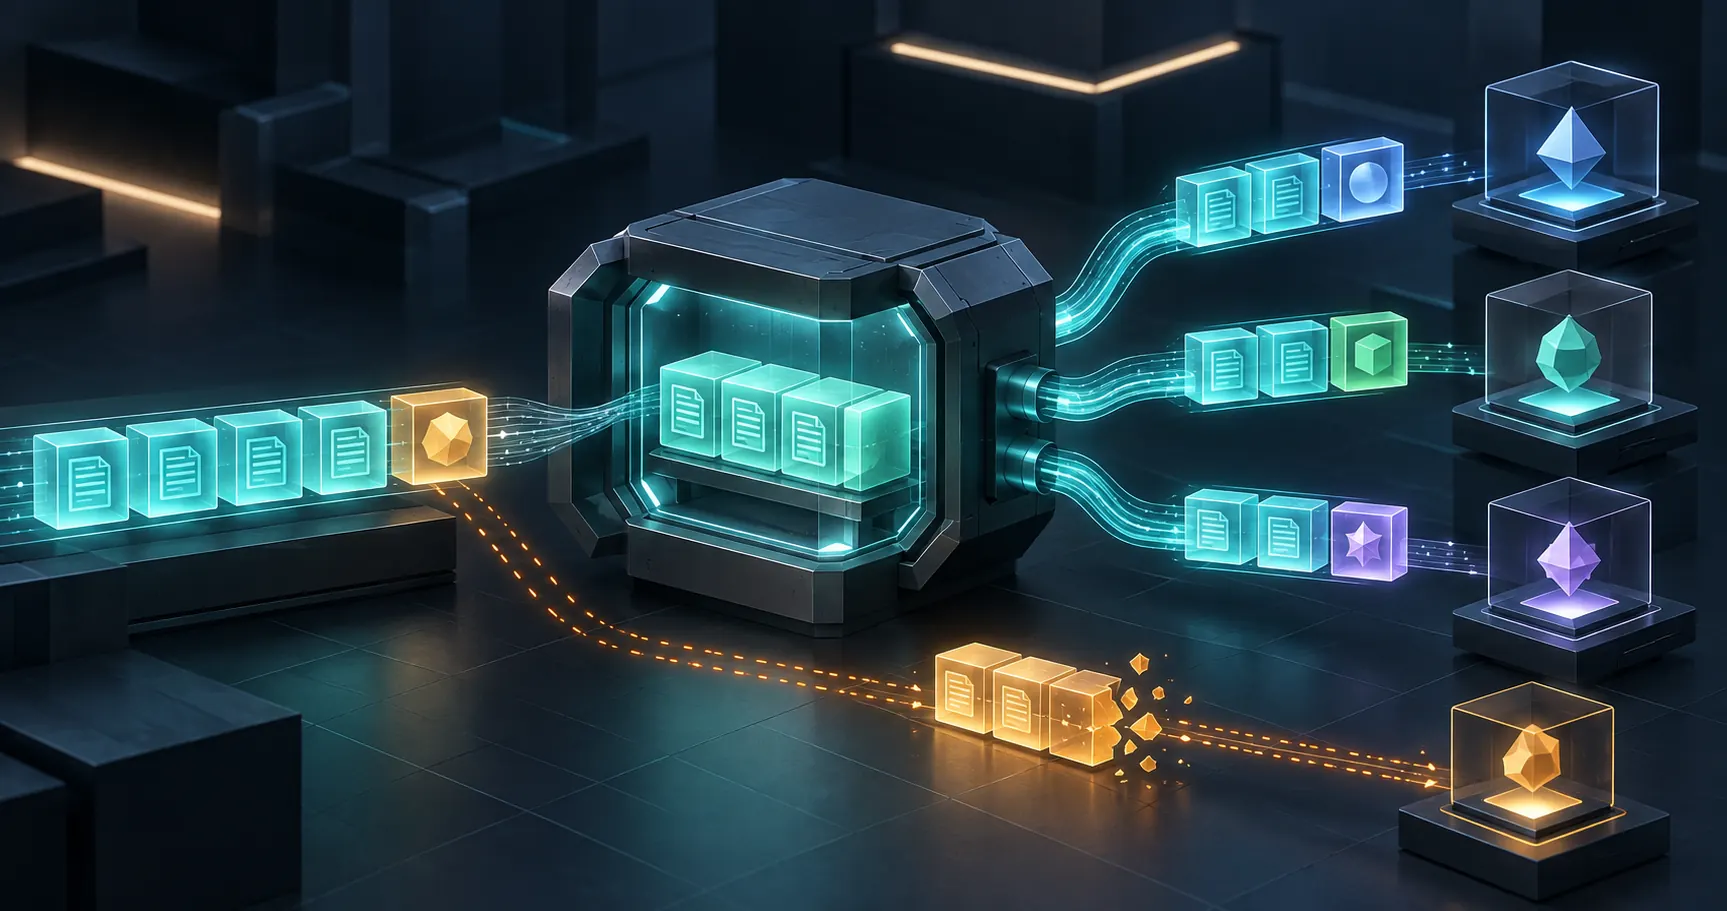
Durante el procesamiento de entrada, el modelo produce estados intermedios KV para atender a tokens anteriores. El caché conserva ese estado para un prefijo idéntico; una solicitud posterior puede leerlo y procesar únicamente la parte nueva. No almacena una respuesta terminada ni garantiza que dos ejecuciones produzcan la misma salida. Cambiar un elemento antes del límite reutilizable —un mensaje, una herramienta, su orden o parte del contexto renderizado— puede convertir una lectura esperada en trabajo nuevo.
La guía vigente documenta para GPT-5.6 y posteriores un mínimo de 1,024 tokens visibles para un prefijo elegible, lecturas a 0.1 veces la tarifa de entrada sin caché y escrituras a 1.25 veces. Esos multiplicadores explican por qué la primera solicitud puede costar más y por qué un prefijo que rara vez se reutiliza no mejora necesariamente la factura. También documenta que la entrada completa puede incluir instrucciones del proveedor, mensajes, herramientas, imágenes, documentos y audio compatible: el contrato real es el contexto renderizado, no la plantilla que el equipo cree estar enviando.
Capítulo 03
1. Diseña el prefijo como un contrato versionado
Separa contenido estable y volátil antes de añadir breakpoints. Al inicio coloca instrucciones comunes, schemas de herramientas y referencias que realmente compartirán varias solicitudes. Después del límite deja identidad de usuario, timestamps, permisos calculados, resultados recientes y la pregunta actual. Si un valor cambia por turno dentro del primer mensaje, invalida todo lo que viene después aunque el resto sea idéntico. Registra un hash del prefijo renderizado para detectar esa deriva sin guardar contenido sensible en observabilidad.
Versiona ese contrato junto al prompt, las herramientas y el modelo. No edites turnos anteriores para hacerlos más legibles ni reordenes propiedades de schemas durante la serialización. Cuando necesites compactar una conversación, trátalo como el inicio de un prefijo nuevo y mide el costo de la transición. Un breakpoint explícito debe marcar una frontera semántica estable, no un número arbitrario de tokens. La prueba útil toma dos solicitudes reales y confirma cuántos tokens fueron escritos, leídos o procesados nuevamente.
Capítulo 04
2. Calcula la economía por cohorte y tarea aceptada
No uses solo cache hit rate. Construye por versión una cuenta con tokens de escritura, lectura y entrada sin caché, además de salida, herramientas, reintentos y respuestas descartadas. Multiplica cada categoría por la tarifa y el modo de procesamiento aplicable. La página de precios muestra tarifas distintas para contexto corto y largo, y posibles recargos regionales; por eso un porcentaje aislado no basta para estimar dinero. Compara con una línea base sin el cambio sobre el mismo conjunto de tareas.
La unidad ejecutiva debe ser costo y latencia por tarea aceptada. Un hit puede ser barato y aun así terminar en un resultado incorrecto que exige revisión humana; un prewarm puede reducir espera, pero cobra una escritura incluso si nadie usa después ese prefijo. Segmenta por flujo, longitud y frecuencia de reutilización. Informa p50 y p95 de tiempo al primer token y duración total, junto con tasa de finalización y corrección. Aprueba la optimización solo si mejora una restricción sin degradar las otras.
Capítulo 05
3. Cambia capacidad sin reescribir el pasado
Los agentes no conservan siempre el mismo conjunto de herramientas. Quitar una definición del prefijo porque hoy no se necesita puede romper la reutilización de miles de tokens. El anuncio recomienda mantener definiciones, schemas y orden estables, y limitar la disponibilidad con allowed_tools o tool_choice. Esa técnica separa lo que el modelo conoce de lo que está autorizado a invocar. Sigue aplicando permisos en el ejecutor: preservar caché nunca debe ampliar autoridad.
GPT-6 también documenta cambios de esfuerzo mediante un elemento configuration_update añadido a la conversación, manteniendo estable el esfuerzo de nivel superior para no reescribir el prefijo. Valida la compatibilidad exacta del modelo y endpoint antes de adoptarlo. Para instrucciones nuevas, agrega un mensaje de desarrollador posterior que anule la regla anterior, en vez de editar silenciosamente el primer mensaje. Cuando una regla de seguridad deba reemplazarse de inmediato, acepta el miss y crea una versión nueva; la eficiencia no justifica reutilizar una política obsoleta.
Capítulo 06
Ejemplo hipotético: un agente de soporte con tres ramas
Imagina un agente hipotético que recibe una incidencia, consulta documentación y luego puede abrir una rama de diagnóstico, otra de respuesta al cliente y una tercera de revisión técnica. Las tres comparten instrucciones, catálogo de herramientas, política de privacidad y el historial hasta la clasificación inicial. El equipo coloca un breakpoint después de ese material estable. Cada rama añade su objetivo, permisos actuales y evidencia reciente después del límite, sin copiar y modificar los turnos previos.
La evaluación ejecuta el mismo lote con y sin prewarm, y repite sesiones dentro y fuera de la ventana elegible. Comprueba lectura real de tokens, tiempo al primer token, costo completo y exactitud del cierre. Luego modifica deliberadamente el orden de una herramienta, compacta el historial y rota una política para verificar que los diagnósticos expliquen los misses esperados. El resultado no es prometer un porcentaje: es saber qué ramas reutilizan, cuándo dejan de hacerlo y si la optimización conserva la decisión correcta.
Capítulo 07
4. Aísla cuentas, regiones y datos sensibles
La documentación indica que los estados cacheados viven en máquinas concretas, no se comparten entre organizaciones ni entre límites regionales y siguen sujetos a enrutamiento y capacidad. Por eso una sesión activa no garantiza un hit. En modelos recientes, prompt_cache_key es opcional para optimizar el routing, pero puede separar la contabilidad por cliente o workspace y ayudar a reducir sondeos entre usuarios. No uses una clave derivada de secretos ni la confundas con control de acceso.
Revisa la política de datos antes de cachear documentos, imágenes o conversaciones. Un estado KV no es el texto original, pero sigue siendo estado de aplicación con reglas de retención. Define qué materiales pueden entrar, qué región procesa la solicitud, cuánto dura la elegibilidad y cómo se revoca un prefijo tras un cambio crítico. Los logs deben guardar IDs, versiones, hashes y métricas; evita copiar el prompt completo solo para explicar un miss. Seguridad y trazabilidad deben permanecer aunque el caché falle por completo.
Capítulo 08
5. Trata los misses y la expiración como caminos normales
Prueba primer turno, hit repetido, expiración, desborde por carga, cambio de modelo, mutación de herramientas, compactación y prewarm no consumido. La aplicación debe producir una respuesta válida aunque no haya caché; este es un acelerador, no una dependencia funcional. Configura alertas por caída sostenida de lecturas y aumento de escrituras, pero enlázalas a versión y tráfico para no confundir una campaña nueva con una regresión. Usa los diagnósticos para explicar diferencias, no para declarar automáticamente la causa raíz.
Despliega primero en sombra o en una cohorte de bajo riesgo. Conserva request IDs y conteos de uso suficientes para reconstruir el costo, y fija umbrales antes de mirar resultados. El gate final exige la misma calidad, aislamiento correcto, menor costo por tarea aceptada o menor latencia en el percentil objetivo, y una explicación para los misses principales. Si una métrica mejora a costa de respuestas obsoletas, permisos laxos o más correcciones humanas, la optimización no está aprobada.
Capítulo 09
La decisión es comprar reutilización demostrada
Prompt caching convierte la estructura de una conversación en una decisión de infraestructura. Su valor aparece cuando existe un prefijo suficientemente largo, estable y reutilizado dentro de la ventana; desaparece cuando cada solicitud cambia temprano, llega tarde o se evalúa solo con promedios. Empieza por instrumentar la línea base, diseña una frontera versionada y calcula escrituras y lecturas. Después prueba los caminos que rompen el caché. La novedad de GPT-6 es más útil como capacidad observable que como promesa automática de ahorro.
Aprueba el cambio cuando las cinco decisiones dejan evidencia: contrato estable, economía por tarea, evolución segura de herramientas, aislamiento explícito y evaluación de misses. Si necesitas llevar ese diseño a un flujo real, el servicio a medida de Wasyra puede convertir prompts, permisos, telemetría y casos de prueba en una implementación medible. Ese servicio vive en wasyra.com y es distinto del producto Agents alojado en agents.wasyra.com.
Escrito por
Wasyra Engineering
Modernización, arquitectura y delivery confiable
Wasyra Engineering documenta patrones para mover sistemas legacy sin congelar delivery ni romper ownership.
Serie
Sistemas IA que sí llegan a producción
Una serie sobre agentes, copilots y guardrails para llevar IA al trabajo real sin romper confianza ni operación.
Posts de esta serieMás de este autor
Más de este autor
Ingeniería
IA física híbrida: qué inferencia dejar dentro del robot
Microsoft propone descargar inferencia robótica a edge o cloud. Seis decisiones para ganar capacidad sin entregar seguridad a la red.
ArtículoIngeniería
Claude Opus 5.5: cómo migrar un agente sin romperlo
Claude Opus 5.5 cambia razonamiento, herramientas y progreso. Cinco gates para migrar agentes con evidencia, coste controlado y rollback.
ArtículoSigue leyendo
Sigue leyendo
Ingeniería
IA física híbrida: qué inferencia dejar dentro del robot
Microsoft propone descargar inferencia robótica a edge o cloud. Seis decisiones para ganar capacidad sin entregar seguridad a la red.
ArtículoIngeniería
Claude Opus 5.5: cómo migrar un agente sin romperlo
Claude Opus 5.5 cambia razonamiento, herramientas y progreso. Cinco gates para migrar agentes con evidencia, coste controlado y rollback.
ArtículoIngeniería
Grok 4.7: cómo conservar el razonamiento entre turnos
El lanzamiento de Grok 4.7 cambia el manejo del estado en Responses API. Cinco criterios para conservar contexto, evaluar continuidad y controlar riesgos.
Artículo