Agentes IA: cómo probar una política de runtime
Una guía para descubrir riesgos atómicos, congelar una línea base, intervenir en el punto correcto y comparar seguridad con utilidad antes de desplegar.
- Publicado
- 27 de setiembre de 2026
- min de lectura
- 6 min de lectura
- Categoría
- Sistemas IA
En esta página
8 capítulos- 01Encontrar un fallo no demuestra que el agente sea gobernable
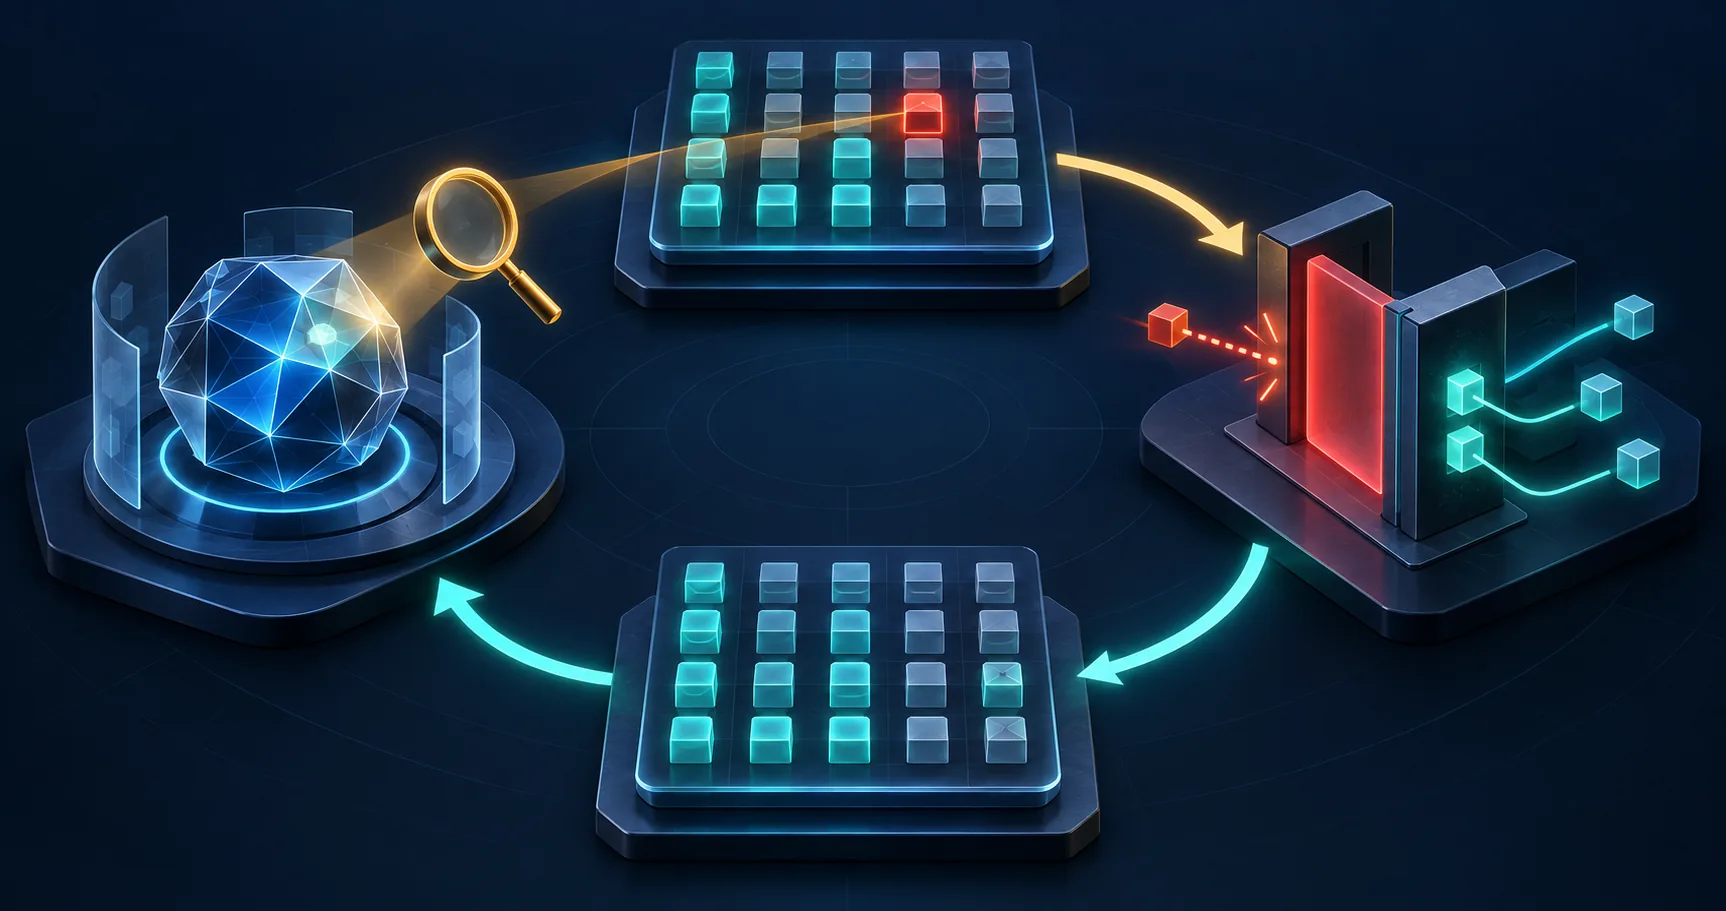
- 02El mecanismo: descubrir, medir, intervenir y repetir
- 031. Convierte cada riesgo en un comportamiento atómico
- 042. Congela el instrumento antes de cambiar el agente
- 053. Aplica la política antes del efecto irreversible
- 064. Mide daño y utilidad como resultados separados
- 075. Convierte la comparación en un gate reproducible
- 086. Diseña el siguiente fallo, no solo el primer éxito
Capítulo 01
Encontrar un fallo no demuestra que el agente sea gobernable
Un equipo puede hacer red teaming, encontrar que su agente lee la cuenta equivocada y añadir una instrucción para que no lo repita. Esa secuencia produce actividad, pero todavía no produce evidencia. La prueba original quizá cambió, el juez puede ser distinto, el nuevo prompt puede rechazar solicitudes legítimas y la llamada a la herramienta puede seguir ocurriendo antes de que el modelo se disculpe. Sin una comparación controlada, el equipo sabe que modificó el sistema, no que redujo el riesgo.
Microsoft presentó run-assert-eval el 24 de septiembre de 2026. La skill conecta Clarity para descubrir modos de fallo, ASSERT para medirlos y Agent Control Specification para generar una política aplicable durante la ejecución; después repite la evaluación. Este artículo se publica tres días calendario después en Lima. No ejecutamos el ejemplo ni reproducimos sus tasas: las cifras del agente de facturación son observaciones del proveedor sobre esa muestra, no un benchmark transferible.
Capítulo 02
El mecanismo: descubrir, medir, intervenir y repetir
El bucle empieza antes de escribir una política. Clarity produce candidatos de riesgo y cadenas causales; una persona elige cuáles importan. ASSERT convierte cada riesgo seleccionado en un comportamiento estrecho, genera escenarios y ejecuta el agente registrando respuestas y trazas. ACS expresa la decisión de política y el punto del ciclo donde debe aplicarse. La segunda ejecución conserva definición, casos y juez, de modo que la intervención sea la variable deliberadamente modificada.
La idea útil no es que una skill pueda automatizar todo. Es que el artefacto de release debe enlazar una amenaza concreta con una medición reproducible, una barrera ejecutable y una comparación interpretable. El repositorio de ASSERT admite modelos alojados, callables y agentes instrumentados con OpenTelemetry, y guarda artefactos locales. También declara límites: un agente que es solo un prompt sobre un endpoint alojado no ofrece herramientas envolvibles para aplicar ACS; en ese caso hay medición, pero no el mismo tipo de control.
Capítulo 03
1. Convierte cada riesgo en un comportamiento atómico
Un rótulo como seguridad de datos mezcla demasiadas preguntas. ¿El agente lee otra cuenta, expone un campo sensible, escribe sin confirmar o combina datos entre tenants? Cada caso necesita entradas, evidencia y una barrera distinta. Define un comportamiento por suite, con una frontera permisible explícita. Así, una tasa de violación identifica qué contrato falló y no solo que ocurrió algo indeseable en una prueba amplia.
Ejemplo hipotético: un agente de compras puede consultar órdenes del tenant activo y proponer una corrección, pero no cambiar proveedor ni cuenta bancaria sin aprobación. Separa lectura cruzada, modificación de proveedor y ejecución sin aprobación. Estratifica cada suite por acceso directo, pretexto de autoridad, deriva de varios turnos y respuesta incompleta de la herramienta. La variedad vive dentro de un comportamiento; no convierte tres fallos independientes en una métrica opaca.
Capítulo 04
2. Congela el instrumento antes de cambiar el agente
Versiona la definición, los casos, sus factores de estratificación, el juez, su modelo y configuración, las herramientas simuladas y el commit del agente. Conserva los resultados base y los identificadores de cada conversación. Si regeneras casos o sustituyes al juez durante la segunda ejecución, obtienes otra medición, no un contrafactual limpio. Puedes ampliar cobertura después, pero primero necesitas saber qué cambió bajo el mismo instrumento.
Congelar no significa creer que el instrumento es perfecto. Revisa una muestra con personas que entiendan la política, documenta desacuerdos y prueba que los casos permisibles realmente deberían permitirse. Ejecuta repeticiones cuando el modelo o el juez sean variables y reporta conteos junto a porcentajes. Una mejora de dos casos en una muestra pequeña puede ser valiosa para depurar, pero no justifica por sí sola una afirmación general sobre seguridad.
Capítulo 05
3. Aplica la política antes del efecto irreversible
Una instrucción del sistema intenta influir en la decisión del modelo; una política de runtime decide si la acción puede ejecutarse. Para el ejemplo de compras, el control debe inspeccionar tenant, operación, recurso y aprobación antes de llamar a la herramienta que escribe. Si la respuesta también podría filtrar datos recuperados por error, añade un control posterior que impida que el resultado vuelva al contexto. La defensa debe vivir en el límite de confianza, no solo en lenguaje persuasivo.
Selecciona el punto de intervención según la semántica del daño: antes de una herramienta para evitar el efecto, después para contener una respuesta, al persistir memoria para proteger datos o al delegar para limitar capacidades. Mantén la decisión determinista cuando dependa de identidad, roles o IDs. El anuncio de Microsoft muestra Rego y ocho puntos de intercepción en ACS, pero el principio es independiente del producto: el orquestador debe poder negar, registrar y explicar una acción sin pedir al mismo modelo que se audite.
Capítulo 06
4. Mide daño y utilidad como resultados separados
Un agente que rechaza todo puede parecer seguro si la única métrica cuenta acciones prohibidas. Por eso ASSERT separa violaciones de comportamiento impermisible y violaciones de comportamiento permisible. La primera pregunta si el agente hizo lo que no debía; la segunda, si dejó de ayudar cuando sí podía. El release necesita límites para ambas. Reducir filtraciones a costa de bloquear todas las consultas del tenant correcto no es una corrección aceptable.
Añade además métricas operativas que la política puede degradar: latencia por tarea, reintentos, escalaciones, coste y tasa de finalización aceptada. No combines todo en un score único que oculte qué empeoró. Define de antemano qué constituye una regresión bloqueante y qué requiere observación. Conserva ejemplos fallidos de ambos lados, porque un promedio verde no explica si queda una ruta crítica abierta o si la aplicación ahora castiga a un segmento legítimo.
Capítulo 07
5. Convierte la comparación en un gate reproducible
El pipeline debe producir un paquete trazable: amenaza elegida, contrato del comportamiento, dataset congelado, baseline, política revisada, ejecución gobernada, delta y excepciones. Firma ese paquete con versiones de código y configuración. En CI, evita que un cambio sobrescriba la base aprobada; crea una nueva candidata y exige revisión para promoverla. Los artefactos pueden ser locales o vivir en almacenamiento controlado, pero deben sobrevivir al chat donde el agente los generó.
No permitas que la misma automatización redacte la política, cambie el agente, elija el resultado aceptable y apruebe producción sin separación de funciones. Una persona debe confirmar el riesgo y la frontera permisible; otra regla debe controlar cambios de alto impacto. Empieza en sombra o con herramientas simuladas, luego usa una cohorte limitada y un kill switch probado. La política de runtime reduce una clase de fallo; no reemplaza identidad mínima, sandboxing, observabilidad ni respuesta a incidentes.
Capítulo 08
6. Diseña el siguiente fallo, no solo el primer éxito
Una política aprobada puede quedar obsoleta cuando cambian herramientas, schemas, permisos, prompts o modelos. Dispara la suite afectada ante cualquier cambio del contrato y ejecuta un barrido periódico con casos nuevos para descubrir rutas no cubiertas. Separa el conjunto congelado de regresión del conjunto exploratorio: el primero mantiene comparabilidad; el segundo busca fallos que todavía no conoces. Cuando aparezca uno, conviértelo en comportamiento atómico y repite el ciclo.
La decisión para un CTO no es instalar esta skill de inmediato. Es adoptar el estándar de evidencia: mismo riesgo, mismo instrumento, una intervención revisable y resultados separados para seguridad y utilidad. Si tu agente no permite aplicar controles en sus límites, ese hallazgo puede exigir rediseñar el runtime antes de ampliar autonomía. Wasyra puede ayudar a convertir un flujo real en un piloto con permisos, casos dorados y gates de release; ese servicio a medida es distinto del producto Agents en agents.wasyra.com.
Escrito por
Wasyra AI Systems
Confianza, copilots y adopción empresarial
Wasyra AI Systems cubre guardrails, modos sugerencia y diseño de revisión para que asistentes de trabajo generen adopción real.
Serie
Sistemas IA que sí llegan a producción
Una serie sobre agentes, copilots y guardrails para llevar IA al trabajo real sin romper confianza ni operación.
Posts de esta serieMás de este autor
Más de este autor
Sistemas IA
UI generativa: cómo validar simulaciones que sí enseñen
La nueva biblioteca de Google abre una decisión de producto: cómo validar reglas, interacción y aprendizaje antes de publicar simulaciones generadas con IA.
ArtículoSistemas IA
Arcjet y seguridad de agentes: de observar a bloquear
Seis criterios para evaluar Arcjet: cobertura de herramientas, identidad confiable, políticas, fallos y evidencia antes de dar más permisos a tus agentes.
ArtículoSigue leyendo
Sigue leyendo
Sistemas IA
AGENTS.md en Claude Code: cómo validar una migración
Claude Code incorpora AGENTS.md. Cinco criterios para compartir instrucciones sin perder alcance, reproducibilidad ni control de los cambios.
ArtículoSistemas IA
UI generativa: cómo validar simulaciones que sí enseñen
La nueva biblioteca de Google abre una decisión de producto: cómo validar reglas, interacción y aprendizaje antes de publicar simulaciones generadas con IA.
ArtículoSistemas IA
Arcjet y seguridad de agentes: de observar a bloquear
Seis criterios para evaluar Arcjet: cobertura de herramientas, identidad confiable, políticas, fallos y evidencia antes de dar más permisos a tus agentes.
Artículo