Decisions API: siete gates para producción
OpenAI llevó Decisions API a disponibilidad general para convertir texto, imágenes y JSON en predicados, elecciones o scores. Esta guía explica dónde encaja el endpoint, cómo separar clasificación de ejecución y qué evaluación exige una decisión antes de entrar en el camino crítico de un producto.
- Publicado
- min de lectura
- 8 min de lectura
- Categoría
- Sistemas IA
En esta página
8 capítulos- 01¿Cuándo conviene usar Decisions API?
- 02Cómo funciona una decisión acotada
- 03Ejemplo hipotético: enrutar una devolución
- 04¿Cuándo necesitas Responses, reglas o revisión?
- 05Siete gates antes de automatizar
- 06Cómo evaluar confianza y umbrales
- 07Costo, caché y riesgos operativos
- 08La decisión es el producto, no el endpoint
Capítulo 01
¿Cuándo conviene usar Decisions API?
Decisions API conviene cuando una aplicación debe responder una pregunta frecuente con un conjunto cerrado de salidas y la velocidad importa: comprobar una condición, elegir una ruta o puntuar contra una rúbrica. El contrato debe poder escribirse antes de llamar al modelo, los errores deben medirse con ejemplos etiquetados y una respuesta incierta necesita una salida segura. No sustituye generación, extracción abierta ni herramientas. OpenAI anunció su disponibilidad general el 22 de octubre de 2026, dos días antes de esta publicación en America/Lima, con GPT-6 Luna, entradas de texto, imágenes o JSON y hasta 400 preguntas por solicitud. La novedad reduce la fricción técnica para poner clasificadores en caminos interactivos, pero no elimina el trabajo de producto: definir opciones que no se solapen, calibrar umbrales por costo de error, separar la respuesta de la acción y observar cambios de distribución. La arquitectura responsable empieza por una decisión estrecha y reversible, no por convertir cada paso del workflow en una inferencia.
El anuncio afirma que el endpoint produce decisiones acotadas hasta diez veces más rápido que GPT-6 Luna mediante Responses API. También publica casos de clientes con mejoras de latencia o costo. Son resultados del proveedor y de cargas concretas, no una promesa para cualquier sistema. Un equipo debe tratarlos como una razón para ejecutar su propio experimento: misma evidencia, misma taxonomía, mismo conjunto de casos y medición p50, p95, calidad y tasa de revisión. La comparación útil no es «Decisions contra un modelo lento»; es la nueva ruta contra el sistema que hoy resuelve esa decisión, incluido código determinista cuando baste.
El candidato ideal aparece muchas veces, tolera una salida acotada y hoy paga latencia por generar texto que nadie necesita. El mal candidato requiere explicar una política, redactar una respuesta, reunir datos faltantes, ejecutar una herramienta o encadenar razonamiento dependiente. En esos casos, una decisión rápida puede participar como señal, pero no debería fingir que completó el trabajo. La ganancia arquitectónica llega cuando el contrato pequeño reduce variabilidad y costo sin borrar contexto, supervisión ni responsabilidad.
Capítulo 02
Cómo funciona una decisión acotada
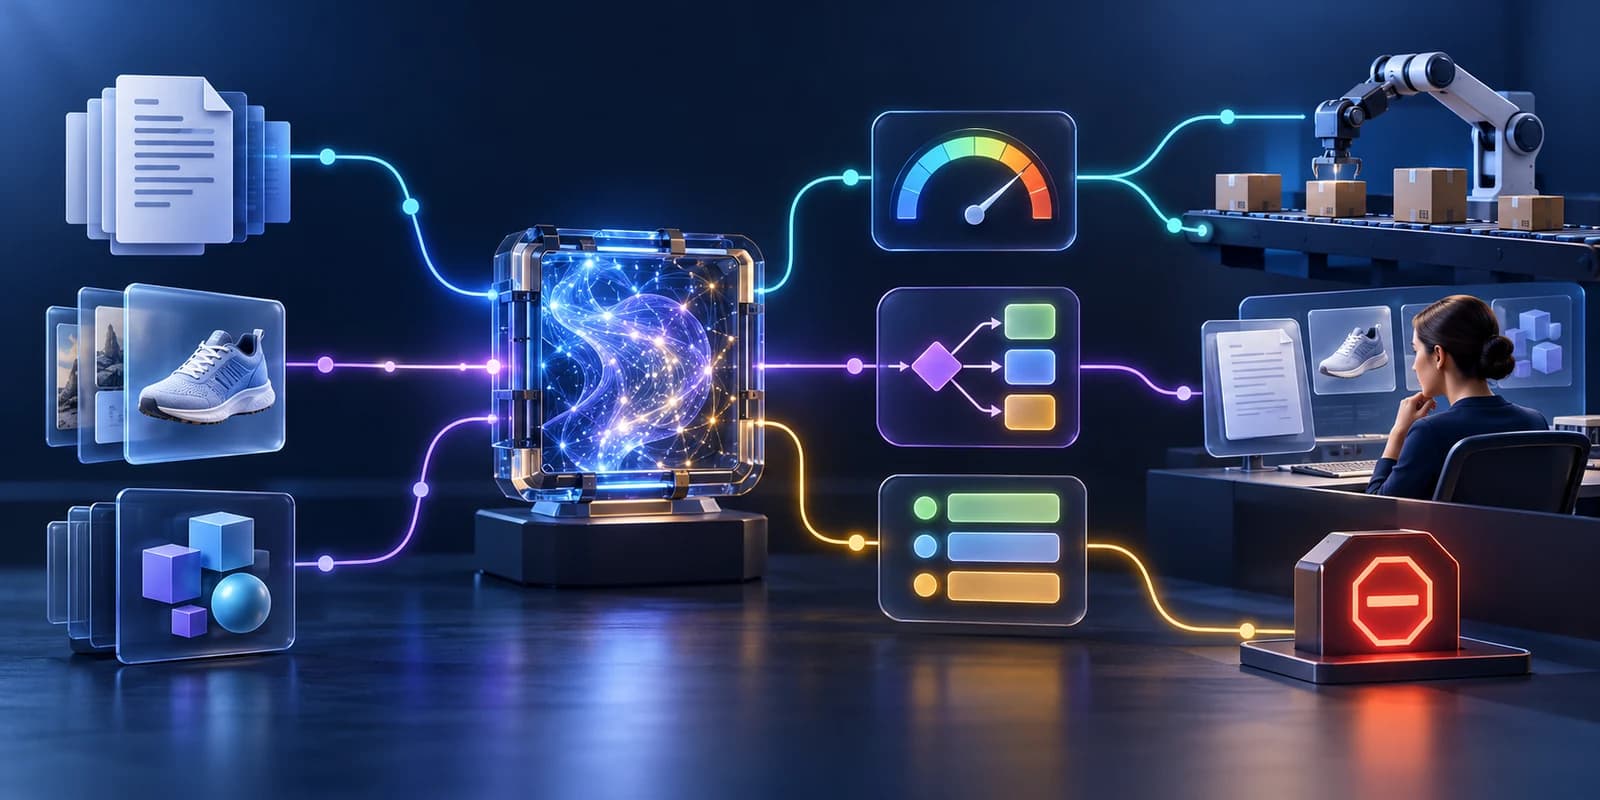
Una solicitud separa evidencia compartida y preguntas. La evidencia puede ser texto, mensajes con historial de herramientas, imágenes o datos estructurados. Cada pregunta recibe un nombre estable, instrucciones y un tipo de respuesta. Predicate estima la probabilidad de una condición; choice distribuye probabilidad entre opciones sin orden; score calcula un valor sobre niveles ordenados. El servicio devuelve un arreglo de respuestas asociado a los nombres, lo que permite que el código consuma un contrato pequeño en vez de analizar prosa libre.
La documentación permite agrupar preguntas independientes sobre la misma evidencia. Eso puede ahorrar transporte y reutilizar contexto, pero no convierte un lote en un grafo de razonamiento. Si la segunda pregunta depende de la primera, OpenAI indica enviar solicitudes separadas. Esa frontera importa: preguntar simultáneamente «¿hay daño?» y «¿qué reparación corresponde?» puede ocultar que la segunda carece de sentido cuando no hay daño. La aplicación debe representar la dependencia, persistir la primera respuesta y decidir si formula la siguiente.
| Tipo | Úsalo para | No lo confundas con |
|---|---|---|
| Predicate | Una condición observable con umbral | Una autorización automática |
| Choice | Opciones mutuamente distinguibles | Texto libre o categorías superpuestas |
| Score | Niveles ordenados con criterios explícitos | Una medida física o probabilidad calibrada |
Capítulo 03
Ejemplo hipotético: enrutar una devolución
Imagina un comercio que recibe una foto del producto, el motivo escrito por el comprador, el SKU y el historial del pedido. Este ejemplo es hipotético. Una primera pregunta predicate estima si la imagen muestra daño visible. Una choice clasifica la solicitud como daño, talla, entrega incompleta, arrepentimiento u otro. Una score ordena la urgencia de revisión con una rúbrica definida. La respuesta no aprueba el reembolso: produce señales para que reglas de negocio combinen plazo, monto, fraude conocido, inventario y política regional.
El contrato necesita tres salidas además de las categorías felices. «Evidencia insuficiente» cubre fotos ilegibles o campos ausentes. «Fuera de taxonomía» evita forzar un caso nuevo en la opción más parecida. «Revisión humana» recibe respuestas de baja confianza o alto impacto. Cada señal conserva versión de instrucciones, modelo, hash de evidencia y decisión posterior de la aplicación. Así el equipo puede reconstruir por qué un caso tomó una ruta, volver a evaluarlo con una versión nueva y medir si la automatización redujo trabajo sin elevar errores costosos.
Capítulo 04
¿Cuándo necesitas Responses, reglas o revisión?
Decisions responde preguntas cerradas. Structured Outputs con Responses encaja cuando necesitas generar un objeto propio con campos variables, extracción o explicación. Function calling encaja cuando el modelo debe solicitar una herramienta con argumentos. Las reglas deterministas siguen ganando cuando la respuesta vive en datos exactos: país permitido, fecha vencida, monto sobre un límite o rol sin permiso. Un revisor humano entra cuando el error tiene costo legal, financiero, físico o reputacional que el conjunto de evaluación todavía no controla.
Una arquitectura práctica usa capas. Primero valida esquema, permisos y condiciones duras con código. Después usa Decisions solo para la ambigüedad semántica que el código no resuelve bien. Luego una política combina la señal con contexto operativo y selecciona automatización, revisión o rechazo seguro. Finalmente, Responses puede redactar una explicación apoyada en datos ya decididos, sin volver a decidir silenciosamente. Esta separación hace observable cada responsabilidad y evita que una respuesta fluida cambie una regla de negocio.
| Necesidad | Mecanismo | Gate principal |
|---|---|---|
| Hecho exacto o política dura | Código determinista | Pruebas de reglas y datos |
| Condición, categoría o nivel | Decisions API | Matriz de errores y umbrales |
| Objeto, explicación o texto | Responses API | Esquema, groundedness y calidad |
| Acción externa | Herramienta más autorización | Permisos, idempotencia y auditoría |
Capítulo 05
Siete gates antes de automatizar
La velocidad solo crea valor cuando el contrato, la calidad y la ruta de fallo están definidos. Estos siete gates convierten una demo de clasificación en una decisión operable.
Primero, fija el alcance: una pregunta observable y una acción reversible. Segundo, diseña la taxonomía: opciones exhaustivas para el dominio conocido, distinguibles entre sí y con salida desconocida. Tercero, versiona evidencia e instrucciones para reproducir cada respuesta. Cuarto, construye un set etiquetado que incluya casos frecuentes, bordes, datos incompletos y ejemplos fuera de distribución. Estos cuatro gates prueban que el equipo sabe qué pregunta formula y puede reconocer una respuesta incorrecta.
Quinto, calibra umbrales según el costo de falsos positivos y falsos negativos; una sola cifra global rara vez sirve a todas las rutas. Sexto, separa decisión y efecto con una política explícita, idempotencia y autorización para acciones sensibles. Séptimo, opera la ruta: observa latencia, errores, abstenciones, mezcla de clases, revisión y drift; define rollback hacia reglas, el sistema anterior o revisión total. Ningún benchmark del proveedor reemplaza estos gates porque ninguno conoce el costo de equivocarse en tu producto.
- Alcance estrecho y reversible
- Taxonomía con desconocido y evidencia insuficiente
- Versionado reproducible
- Set etiquetado representativo
- Umbrales por costo de error
- Política y autorización separadas
- Observabilidad, drift y rollback
Capítulo 06
Cómo evaluar confianza y umbrales
Empieza con una matriz de confusión por clase y por segmento relevante, no con accuracy agregada. Para un predicate, traza precisión y recall a varios umbrales. Para choice, inspecciona confusiones entre cada par de opciones y la relación entre confianza y acierto. Para score, mide si niveles adyacentes mantienen el orden esperado y si el valor medio oculta desacuerdos entre extremos. Separa los casos que el sistema abstiene: enviarlos a revisión es una conducta válida, no un error que debas esconder.
Ejecuta primero en shadow mode. La nueva ruta responde, pero el sistema anterior conserva autoridad. Compara decisiones y recoge adjudicación humana sobre desacuerdos. Después habilita solo una banda de bajo riesgo: casos con evidencia completa, clase conocida y margen suficiente. Mantén un holdout que no se use para ajustar instrucciones y repite evaluación cuando cambien modelo, preguntas, opciones, input, política o población. El SDK oficial de Node publicado el 22 de octubre amplió los tipos aceptados en instrucciones e inputs; incluso un cambio compatible puede romper código que asumía strings o roles cerrados, por lo que la integración también necesita pruebas de contrato.
Capítulo 07
Costo, caché y riesgos operativos
Al publicarse este artículo, OpenAI declara USD 0,10 por millón de tokens de entrada y USD 0,01 para entrada en caché, sin cobro por tokens de salida. Son precios temporales: confirma la página vigente antes de presupuestar. Modela costo por decisión aceptada, no por llamada. Incluye tokens, escritura de caché, reintentos, preguntas agrupadas, tasa de revisión y costo humano. El caching ayuda cuando un prefijo compartido de al menos 1.024 tokens permanece idéntico; no justifica inflar contexto ni esconder datos cambiantes detrás de una clave estable.
Los riesgos operativos son menos vistosos que la latencia. Un timeout no significa «false»; un JSON inválido no significa «other»; una clase nueva no debe caer silenciosamente en la más cercana. Registra error de transporte, error del proveedor, abstención, baja confianza y rechazo de política como estados distintos. Limita concurrencia, usa backoff, protege datos sensibles y monitorea uso por proyecto o clave. Si la decisión vive en el hot path, ensaya degradación: reglas conservadoras, cola para revisión o experiencia parcial. La aplicación debe seguir siendo segura cuando el modelo no responde.
Capítulo 08
La decisión es el producto, no el endpoint
Decisions API abre una ruta atractiva para clasificación y scoring interactivos: contrato pequeño, entrada multimodal, varias preguntas independientes y una superficie de costo enfocada. Su valor no está en reemplazar Responses en bloque, sino en extraer del flujo aquellas decisiones repetitivas que ya pueden nombrarse, etiquetarse y evaluarse. Cuanto más estrecha sea la pregunta, más claro será cuándo una respuesta es incorrecta y más fácil será diseñar un fallback.
Empieza con una decisión de alto volumen y bajo impacto. Escribe la taxonomía, etiqueta casos reales, mide contra la ruta actual y ejecuta en sombra. Solo automatiza el segmento cuyo costo de error esté controlado; conserva revisión, versionado y rollback. Si tu equipo necesita convertir un workflow ambiguo en contratos evaluables, Wasyra puede ayudar a diseñar la arquitectura y el piloto, sin confundir una señal del modelo con autoridad para actuar.
Escrito por
Wasyra Lab
Arquitectura de sistemas IA y operaciones
Wasyra Lab publica marcos prácticos para diseñar agentes de IA, automatizaciones y flujos operativos que sí sobreviven producción.
Serie
Sistemas IA que sí llegan a producción
Una serie sobre agentes, copilots y guardrails para llevar IA al trabajo real sin romper confianza ni operación.
Posts de esta serieMás de este autor
Más de este autor
Sistemas IA
Agentes distribuidos: cuándo paralelizar el análisis
Más agentes solo ayudan si el trabajo se divide sin perder evidencia. Siete decisiones convierten paralelismo en cobertura evaluable.
ArtículoSistemas IA
RAG multimodal: siete gates para confiar en la evidencia
Parsear, recuperar y reordenar son contratos distintos. Siete gates ayudan a decidir si una pila multimodal mejora la evidencia sin ocultar nuevos fallos.
ArtículoSigue leyendo
Sigue leyendo
Sistemas IA
Agentes distribuidos: cuándo paralelizar el análisis
Más agentes solo ayudan si el trabajo se divide sin perder evidencia. Siete decisiones convierten paralelismo en cobertura evaluable.
ArtículoSistemas IA
RAG multimodal: siete gates para confiar en la evidencia
Parsear, recuperar y reordenar son contratos distintos. Siete gates ayudan a decidir si una pila multimodal mejora la evidencia sin ocultar nuevos fallos.
ArtículoSistemas IA
Datos sintéticos multilingües: seis gates
Traducir millones de documentos no crea un corpus confiable. Seis gates separan generación, aceptación, evaluación y release multilingüe.
Artículo