Datos sintéticos multilingües: seis gates
NVIDIA y AI4Bharat anunciaron un corpus sintético de aproximadamente 2,8 billones de tokens y publicaron la receta de generación que lo sustenta. Esta guía convierte el avance en una decisión operativa: cómo preservar procedencia, separar generación de aceptación, evaluar por idioma y escritura, evitar leakage entre splits y demostrar valor con un presupuesto de entrenamiento fijo antes de escalar.
- Publicado
- min de lectura
- 7 min de lectura
- Categoría
- Sistemas IA
En esta página
6 capítulos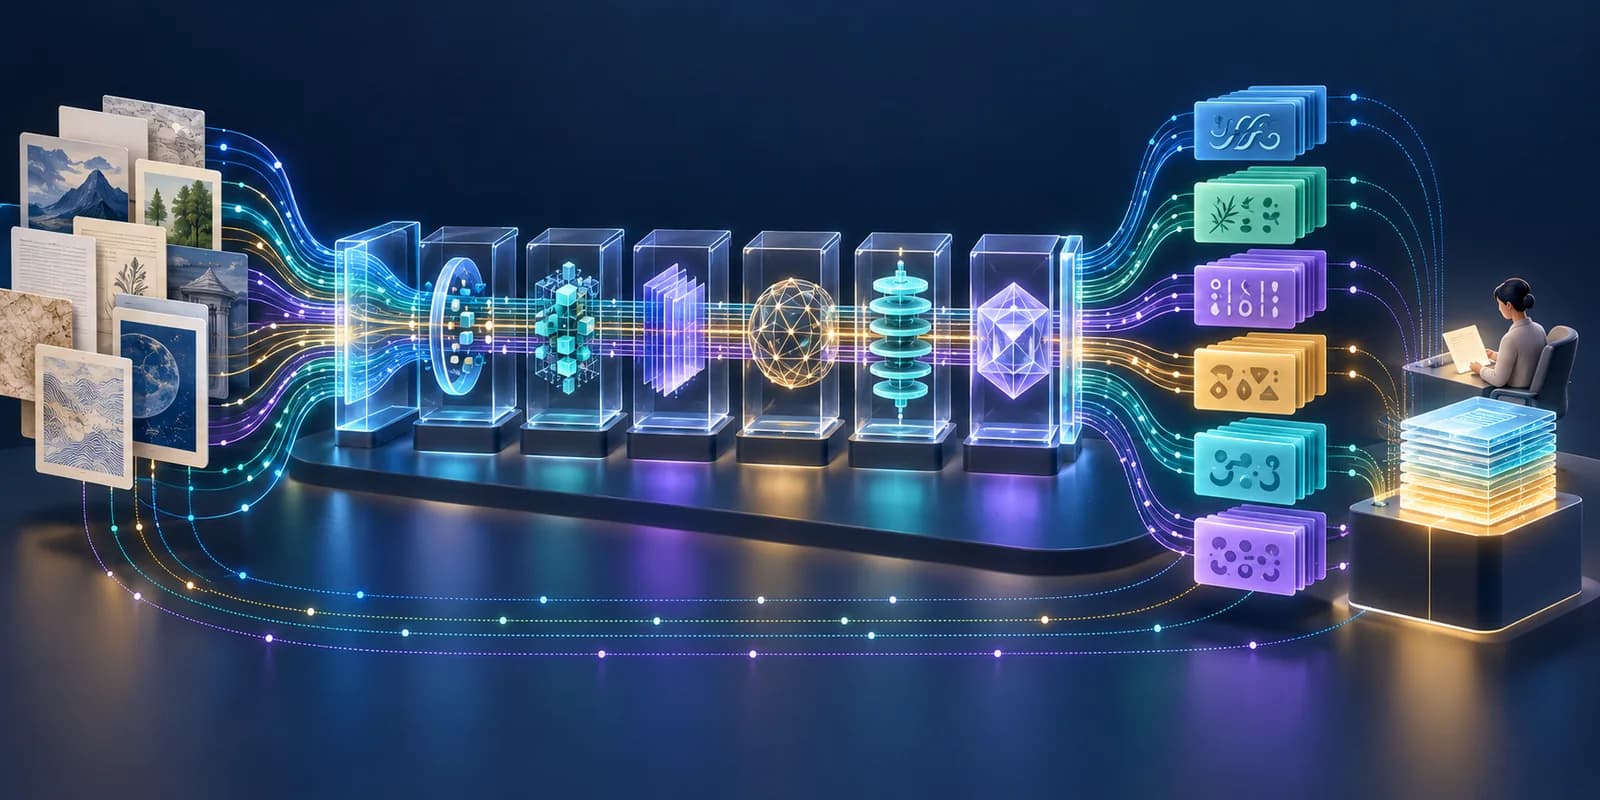
Capítulo 01
¿Cuándo una tubería multilingüe merece escalar?
Escala cuando cada salida puede rastrearse, rechazarse y demostrar utilidad por idioma sin confundir volumen con calidad.
Una tubería de datos sintéticos multilingües merece escalar cuando conserva el documento fuente, separa la generación de la aceptación, mide calidad por idioma y escritura, controla duplicados entre splits y demuestra mejora bajo un presupuesto de entrenamiento fijo. El 16 de octubre de 2026, NVIDIA y AI4Bharat describieron Nemotron-pretraining-Indic-v1: aproximadamente 2,8 billones de tokens generados para 22 lenguas de India y 34 configuraciones de lengua y escritura, junto con una receta abierta de traducción, evaluación y reparación. La noticia tenía tres días calendario en America/Lima al consultarse el 19 de octubre. El corpus amplio se anunció como una publicación próxima; por tanto, la novedad verificable hoy es el mecanismo documentado y el reporte técnico, no la disponibilidad inmediata de todos los datos. Tampoco prueba que traducir más texto mejore cualquier producto: el propio trabajo combina datos sintéticos y naturales, y sus resultados corresponden a esa mezcla y a un modelo concreto.
La decisión para un CTO no es si puede producir más tokens. Es si puede defender por qué una muestra entró al corpus, qué error conocido conserva, quién puede detener el lote y qué comparación mostraría que el entrenamiento valió el costo. Un archivo traducido es un candidato; solo una política de aceptación lo convierte en dato de entrenamiento. Esa separación evita que el generador sea también el dueño silencioso de la calidad y permite reejecutar filtros sin regenerar todo el material.
Capítulo 02
¿Cómo funciona sin convertir traducción en verdad?
La arquitectura útil no es un único prompt: es una cadena trazable con decisiones de aceptación explícitas.
La receta publicada parte de documentos curados en inglés y conserva un identificador que acompaña cada derivado. Para doce lenguas, traduce el documento completo, compara la salida contra la fuente con una rúbrica, repara las salidas de baja puntuación y vuelve a evaluarlas. Solo después genera una variante romanizada de una parte de las traducciones aceptadas. Para otras diez lenguas ajusta el flujo: usa otro modelo de traducción, ventanas solapadas en documentos largos de santali y una conversión de escritura específica para manipuri. El mecanismo importa porque trata idioma, escritura y longitud como propiedades operativas, no como una etiqueta genérica de locale.
Generación, evaluación y reparación producen artefactos distintos. Conviene guardar la fuente inmutable, el candidato, la puntuación por dimensión, los errores detectados, la versión reparada y la decisión final. También hay que fijar versiones de prompts, modelos, tokenizador y configuración. Sin ese linaje, un umbral nuevo no puede reconstruir el corpus y una mejora aparente puede deberse a otra mezcla, otro conteo de tokens o una corrección manual no registrada.
La misma fuente puede originar versiones en varias lenguas y escrituras. Por eso, dividir train, validación y test después de traducir crea leakage: derivados semánticamente equivalentes pueden caer a ambos lados. La unidad de partición debe ser el grupo de procedencia, antes de generar variantes. El conteo de tokens tampoco equivale a documentos únicos ni al presupuesto que finalmente verá el modelo; el anuncio distingue esas tres magnitudes y esa distinción debe permanecer en cualquier tablero interno.
Capítulo 03
¿Qué seis gates deben bloquear el corpus?
Los gates deben evaluar evidencia persistida, no la confianza del equipo ni una media global. Cada uno necesita una condición de rechazo, un responsable y un artefacto auditable. Si una lengua no tiene evaluador competente, si la licencia de una fuente es incierta o si los splits comparten el mismo origen, el lote se detiene aunque el volumen total luzca impresionante.
El umbral es política, no naturaleza. La tubería de referencia usa una rúbrica inspirada en MQM y, para su flujo de doce lenguas, retiene traducciones con al menos 75 de 100. Esa cifra es una puntuación de rúbrica, no 75% de exactitud, y no debe copiarse a otro dominio sin calibración humana. Contratos legales, atención médica o soporte informal exigen distribuciones de errores y tolerancias distintas. El gate correcto define qué severidades son inaceptables para el uso previsto y mide acuerdo entre jueces antes de automatizar el filtro.
| Gate | Evidencia mínima | Motivo de bloqueo |
|---|---|---|
| 1. Derechos y procedencia | Fuente, licencia, hash, versión y cadena de derivados | Origen o permiso no demostrable |
| 2. Cobertura real | Inventario por lengua, escritura, dominio y longitud | Una media oculta segmentos vacíos o dominantes |
| 3. Calidad independiente | Rúbrica por dimensión, muestreo humano y casos adversos | El generador se valida a sí mismo sin calibración |
| 4. Dedupe y splits | Partición por grupo fuente y búsqueda de duplicados semánticos | Derivados equivalentes contaminan evaluación |
| 5. Ablación con presupuesto fijo | Baseline y mezcla candidata con igual cómputo y receta | No se puede aislar el efecto de la mezcla |
| 6. Release reversible | Manifest, métricas por segmento, rollback y monitoreo | No existe forma de reproducir o retirar el lote |
Capítulo 04
¿Cómo probar la idea antes de generar a escala?
Un piloto útil reduce el dominio, conserva la fuente y decide primero cómo perder.
Ejemplo hipotético: una plataforma B2B quiere mejorar un asistente de soporte para español peruano y una segunda variedad lingüística de su mercado. En vez de traducir toda la base, selecciona un dominio acotado —por ejemplo, recuperación de acceso— con documentos vigentes y derechos claros. Antes de generar, crea un conjunto retenido con preguntas reales anonimizadas, respuestas de referencia y criterios de seguridad. Los grupos de documentos fuente se asignan a train o evaluación antes de producir variantes; ninguna traducción hermana puede cruzar la frontera.
El piloto ejecuta traducción, evaluación y reparación como trabajos separados. Revisores competentes inspeccionan muestras estratificadas por intención, longitud y escritura; además reciben casos deliberadamente dañados para comprobar que el juez detecta omisiones, cambio de cifras, residuos del idioma fuente y alteración de instrucciones. Solo después se entrena una variante bajo el mismo presupuesto de la baseline. El release avanza si mejora el segmento objetivo sin degradar seguridad, fidelidad al documento ni desempeño en el idioma dominante.
- Definir el error que obliga a rechazar una muestra antes de observar resultados.
- Mantener natural y sintético como dimensiones separadas de la mezcla.
- Comparar por lengua y escritura; nunca aprobar solo con un promedio agregado.
- Versionar el manifest del corpus para reproducir, excluir y revertir lotes.
Capítulo 05
¿Cómo evaluar sin atribuir una mejora equivocada?
El reporte de Nemotron 3.5 compara el checkpoint anterior y posterior a una etapa de preentrenamiento continuo de 100 mil millones de tokens. Diez mil millones proceden de una mezcla de texto sintético y natural en lenguas de India; los resultados suben en los cinco benchmarks reportados para esa etapa. La lectura responsable es estrecha: la etapa combinada se asocia con esas mejoras en ese modelo. No aísla el aporte del corpus sintético, no demuestra que 2,8 billones de tokens hayan sido consumidos y no establece que la misma receta funcionará igual en otro idioma, dominio o arquitectura.
La evaluación necesita tres capas. La primera mide la muestra: preservación de significado, números, código, formato, fluidez y escritura. La segunda mide el modelo: conocimiento, razonamiento, seguimiento de instrucciones y calidad lingüística por segmento. La tercera mide el producto: recuperación correcta, seguridad, tasa de escalamiento y preferencia humana en tareas reales. Una mejora en la primera no garantiza la tercera, y una métrica global puede ocultar que la lengua con menos datos empeoró.
Hay dos límites especialmente importantes. En parte del flujo publicado, el mismo modelo traduce y juzga, lo que puede favorecer sus propias salidas; la revisión humana es muestral y su cobertura varía por lengua. Además, eliminar duplicados por identificador de proceso no equivale a deduplicar contenido semánticamente similar. Ambos límites deben transformarse en pruebas: un juez independiente o humano para calibrar, y búsqueda de similitud sobre grupos de procedencia antes de cerrar los splits.
Capítulo 06
¿Construir, adaptar o esperar?
Adapta una tubería abierta cuando el idioma objetivo tiene poco material útil, posees fuentes con derechos claros y puedes sostener revisión competente. Compra o contrata capacidad cuando el cuello de botella es la operación de datos, no una ventaja diferencial. Espera cuando no existe un conjunto retenido representativo, no puedes separar derivados entre splits o nadie en el equipo puede juzgar la lengua y el contexto cultural. Generar primero y gobernar después convierte costo de cómputo en deuda de procedencia.
El avance de esta semana es relevante porque publica una arquitectura inspeccionable para una escala poco común y documenta sus límites. La decisión madura no es copiar el volumen ni el umbral. Es adoptar la disciplina: fuente trazable, candidatos separados, aceptación calibrada, splits por linaje, ablación con presupuesto fijo y release reversible. Si esos seis gates caben en el piloto, la escala amplifica evidencia; si no, solo amplifica errores difíciles de retirar.
- Empieza con una decisión de producto y un dominio acotado, no con una meta de tokens.
- Presupuesta revisión nativa y red-team de datos como parte del entrenamiento.
- Publica un manifest interno que explique cada inclusión y exclusión.
Escrito por
Wasyra AI Systems
Confianza, copilots y adopción empresarial
Wasyra AI Systems cubre guardrails, modos sugerencia y diseño de revisión para que asistentes de trabajo generen adopción real.
Serie
Sistemas IA que sí llegan a producción
Una serie sobre agentes, copilots y guardrails para llevar IA al trabajo real sin romper confianza ni operación.
Posts de esta serieMás de este autor
Más de este autor
Sistemas IA
Evaluación continua de agentes: nueve gates
Un agente puede responder rápido y estar equivocado. Nueve gates conectan evaluación offline, release, producción y aprendizaje verificable.
ArtículoSistemas IA
Modelo open-weight: cinco gates antes de alojarlo
Tener los pesos no equivale a controlar el sistema. Cinco gates para decidir si un modelo open-weight merece tu propia infraestructura.
ArtículoSigue leyendo
Sigue leyendo
Sistemas IA
Evaluación continua de agentes: nueve gates
Un agente puede responder rápido y estar equivocado. Nueve gates conectan evaluación offline, release, producción y aprendizaje verificable.
ArtículoSistemas IA
Modelo open-weight: cinco gates antes de alojarlo
Tener los pesos no equivale a controlar el sistema. Cinco gates para decidir si un modelo open-weight merece tu propia infraestructura.
ArtículoSistemas IA
Agentic Autofix: seis gates para aceptar un parche de seguridad
Cerrar una alerta no demuestra que el parche sea seguro. Este marco separa detección, remediación, regresión y decisión de merge.
Artículo