Evaluación continua de agentes: nueve gates
AWS publicó un marco de nueve etapas para evaluar agentes desde la definición de calidad hasta el feedback de producción. Esta guía convierte la novedad en una arquitectura neutral: contratos por herramienta, agente y orquestación; jueces calibrados; canaries; detección de drift y cambios que nunca se aplican automáticamente sin volver a pasar los gates.
- Publicado
- min de lectura
- 7 min de lectura
- Categoría
- Sistemas IA
En esta página
8 capítulos- 01¿Por qué un dashboard verde no prueba calidad?
- 02¿Qué debe contener el contrato de evaluación?
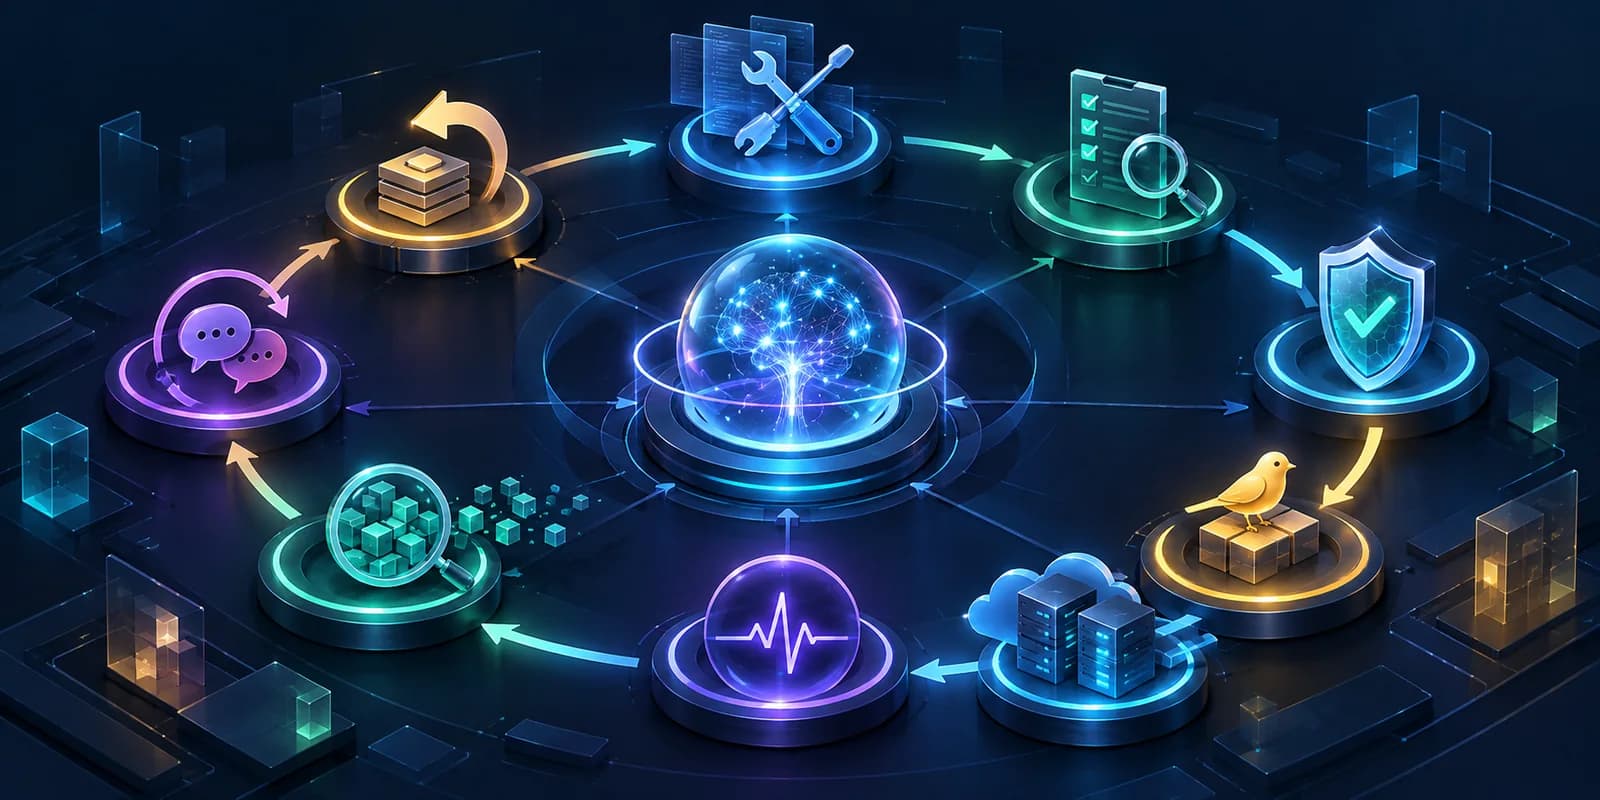
- 03Nueve gates, un solo circuito
- 04¿Cuándo confiar en un LLM como juez?
- 05Ejemplo hipotético: un agente de renovación SaaS
- 06¿Cómo evaluar producción sin capturarlo todo?
- 07¿Qué implementar primero en cuatro semanas?
- 08Conclusión: evalúa decisiones, no solo respuestas
Capítulo 01
¿Por qué un dashboard verde no prueba calidad?
La evaluación continua detecta si un agente sigue tomando decisiones correctas, no solo si responde.
Un agente puede mantener latencia, disponibilidad y tasa de errores técnicas mientras empeora el resultado que recibe el usuario. Una fuente cambia de esquema, el router elige otro subagente, una descripción de herramienta se vuelve ambigua o un modelo actualiza su comportamiento; la respuesta llega con fluidez y el monitor tradicional permanece verde. El 16 de octubre de 2026, AWS publicó un marco de nueve etapas para operar ese riesgo con evaluación desde el primer contrato hasta el tráfico real. La noticia tenía dos días calendario en America/Lima al consultarla el 18 de octubre. Es evidencia de una práctica y una implementación del proveedor, no una garantía universal de calidad.
La decisión para un CTO no es comprar nueve herramientas. Es cerrar un solo circuito: definir éxito, comparar candidatos, bloquear regresiones en CI, aprobar el release, observar canaries, atacar límites, detectar drift, mantener un pulso operativo y convertir fallos confirmados en casos permanentes. Ese circuito necesita operar en tres niveles: herramienta, agente y orquestación. Si solo se puntúa la respuesta final, un número correcto puede ocultar la herramienta equivocada; si solo se prueban herramientas, el orquestador puede combinar resultados incompatibles. Calidad es una propiedad del sistema y de su trayectoria.
Capítulo 02
¿Qué debe contener el contrato de evaluación?
Empieza por la decisión de negocio que el agente debe soportar y tradúcela en fallos observables. Un asistente financiero no necesita una etiqueta abstracta de «calidad»: necesita distinguir cifra sin fuente, moneda incorrecta, período equivocado, entidad confundida, cálculo no autorizado y respuesta fuera de alcance. Cada clase requiere severidad, dueño, evidencia y umbral de promoción. Después añade seguridad, rendimiento, costo y control operativo. Un candidato puede mejorar exactitud media y aun ser inaceptable si amplía permisos, duplica p90 o hace imposible reconstruir qué herramienta produjo una afirmación.
El dataset también es parte del contrato. Separa un conjunto centinela pequeño para cada commit, un golden set más amplio para el gate de release y casos adversariales que intenten forzar fuga de datos, selección de herramientas prohibidas o expansión de alcance. Estratifica por riesgo, idioma, tipo de usuario, fuente, longitud y ruta de herramientas. Conserva estado inicial, respuestas esperadas o aserciones, trayectoria permitida y versión de los datos. La API de evaluación bajo demanda de AgentCore acepta trazas OpenTelemetry y puede recibir respuesta esperada, aserciones y trayectoria de herramientas; ese diseño ilustra por qué un simple par prompt-respuesta resulta insuficiente para un agente.
- Herramienta: argumentos, resultado, permisos, latencia y fallo determinista.
- Agente: logro de objetivo, fundamento, alcance, costo y trayectoria.
- Orquestación: routing, coherencia entre subagentes, síntesis y propagación de errores.
Capítulo 03
Nueve gates, un solo circuito
Cada gate responde una pregunta distinta y produce evidencia para el siguiente.
La secuencia de AWS es útil como mapa, pero debe adaptarse al riesgo y al ritmo de cada producto. Foundation define qué significa «bien»; Experiment compara versiones; Merge encuentra regresiones rápidas; Gate decide si el candidato merece producción; Canary busca fallos posteriores al deploy; Adversary empuja límites de seguridad y calidad; Drift compara segmentos y tiempo; Pulse permite diagnosticar ahora; Feedback convierte incidentes validados en cambios y nuevos casos. No son nueve ceremonias independientes: comparten datasets, taxonomía, versiones y trazas.
| Etapa | Evidencia mínima | Decisión |
|---|---|---|
| 1. Foundation | Taxonomía, umbrales y golden set | Definir el contrato |
| 2. Experiment | Comparación pareada y costo | Elegir candidato |
| 3. Merge | Centinela por tool, agente y flujo | Aceptar el cambio |
| 4. Gate | Replay estable del golden set | Promover o bloquear |
| 5. Canary | Tráfico limitado más sintéticos | Expandir o revertir |
| 6. Adversary | Casos de abuso y límites | Cerrar brechas |
| 7. Drift | Cohortes y baseline temporal | Investigar degradación |
| 8. Pulse | Alarma vinculada a la traza | Diagnosticar y contener |
| 9. Feedback | Fallo confirmado y caso nuevo | Mejorar y revalidar |
Capítulo 04
¿Cuándo confiar en un LLM como juez?
Un juez probabilístico sirve para propiedades semánticas como fundamento, relevancia o completitud, pero no debe reemplazar un oráculo disponible. Usa código para esquemas, permisos, importes, identificadores, SQL, invariantes, selección exacta de herramientas y ausencia de secretos conocidos. Usa revisión humana para ambigüedad de dominio, severidad y calidad editorial. Reserva el juez LLM para criterios cuya rúbrica pueda escribirse, ejemplificarse y auditarse. La documentación de AgentCore distingue evaluadores integrados, de terceros, personalizados con LLM y personalizados en código; la elección correcta depende de la propiedad que se quiere probar, no de la comodidad del dashboard.
Calibra cada juez contra un set etiquetado por personas competentes y mide falsos positivos, falsos negativos y acuerdo por clase, no solo correlación global. Versiona modelo, prompt, escala y ejemplos; vuelve a calibrar si alguno cambia. Mantén casos frontera fuera del set usado para ajustar la rúbrica. Cuando el juez discrepe con un oráculo determinista, el oráculo gobierna. Cuando discrepe con humanos, no promedies hasta ocultar el conflicto: revisa la definición. Un score continuo parece preciso, pero puede comprimir errores graves y preferencias estilísticas en el mismo decimal.
Capítulo 05
Ejemplo hipotético: un agente de renovación SaaS
Imagine un agente que prepara renovaciones: consulta CRM, facturación, tickets y uso; luego redacta un resumen y recomienda una acción. El equipo cambia el conector de billing y todas las llamadas siguen devolviendo HTTP 200. Sin embargo, el campo de moneda ahora llega vacío para una cohorte latinoamericana. El agente completa el símbolo desde el país y produce cifras plausibles. Disponibilidad, latencia y errores permanecen normales; la calidad se degradó sin una caída visible.
El contrato habría detectado el problema en varias capas. Un test de herramienta exige código y moneda de la fuente, no inferencia. El centinela de CI contiene dos cuentas multimoneda. El gate de release reproduce respuestas validadas y compara candidato contra producción. El canary envía una consulta sintética después del deploy. Drift segmenta por región y detecta una caída de grounding aunque el promedio global apenas cambie. Pulse enlaza la alarma con la traza y la versión del conector. Feedback añade el incidente al golden set, pero el parche propuesto vuelve a pasar los nueve gates; no se promueve porque una recomendación automática parezca convincente.
Este ejemplo es hipotético. No describe un cliente, una medición ni experiencia de Wasyra. Su propósito es mostrar que un mismo fallo debe ser detectable antes y después del deploy, y atribuible a una herramienta específica sin guardar indiscriminadamente prompts, tickets o datos de clientes.
Capítulo 06
¿Cómo evaluar producción sin capturarlo todo?
La evaluación online necesita muestreo deliberado. Combina una muestra aleatoria para detectar tendencias con sobre-muestreo de rutas críticas, versiones nuevas, herramientas sensibles, sesiones largas y cohortes donde el modelo tiene menos evidencia. Añade tráfico sintético estable para distinguir drift del sistema de cambios en la mezcla de usuarios. La configuración online documentada por AgentCore permite seleccionar fuentes de trazas, filtros, tasa de muestreo y hasta 25 evaluadores. Ese límite es una capacidad técnica; no implica que activar más evaluadores produzca mejor señal.
Registra identificadores de versión, trayectoria, resultado normalizado y scores necesarios, con retención y acceso explícitos. El artículo anterior sobre telemetría de agentes explica por qué observabilidad no exige copiar contenido completo. Para una investigación, habilita contenido solo en una ventana acotada y autorizada. Conserva además un holdout que no alimente recomendaciones: si cada fallo evaluado se usa inmediatamente para ajustar prompt o herramientas, el sistema puede optimizar el juez sin mejorar el trabajo real.
Capítulo 07
¿Qué implementar primero en cuatro semanas?
Semana uno: elige un flujo de alto valor y alcance estrecho; define cinco a diez clases de fallo, severidad y un golden set pequeño revisado por dominio. Semana dos: instrumenta versión de modelo, prompt, datos y herramientas; añade oráculos deterministas y calibra solo los jueces semánticos necesarios. Semana tres: conecta un centinela a CI y un replay más amplio al release; exige comparación contra el baseline actual y bloquea cualquier violación de seguridad aunque mejore el promedio. Semana cuatro: despliega canary, sintéticos, muestreo por riesgo, alarmas con runbook y rollback practicado.
No automatices el feedback hasta que el equipo pueda explicar falsos positivos, reconstruir una traza y revertir una versión. Las recomendaciones sobre prompts o descripciones de herramientas son candidatos, no cambios aprobados. Revisa semanalmente fallos nuevos y cobertura; mensualmente retira casos redundantes sin borrar incidentes de alta severidad. Mide costo por sesión evaluada, tiempo hasta detectar, tiempo hasta atribuir, regresiones bloqueadas y fallos escapados. Un score único sirve para un resumen; la decisión necesita la distribución por clase y cohorte.
- No promociones por promedio si una clase crítica empeora.
- No uses el mismo set para ajustar y para afirmar mejora.
- No conviertas producción en dataset sin propósito, acceso y retención.
- No cierres el loop con cambios automáticos que eviten los gates.
Capítulo 08
Conclusión: evalúa decisiones, no solo respuestas
El aporte del marco de nueve etapas no es una lista más extensa de métricas. Es unir definición, release, tráfico real e incidentes bajo el mismo contrato versionado. Empieza con un flujo, tres niveles de evidencia y pocos fallos que el negocio realmente entiende. Combina oráculos deterministas, jueces calibrados y revisión humana. Después amplía cobertura según incidentes y riesgo, no según la cantidad de evaluadores disponibles.
Si necesitas llevar un agente desde un demo hasta un sistema operable, Wasyra puede ayudarte a diseñar datasets, herramientas, permisos, trazas y gates de promoción. El objetivo no es declarar al agente «confiable» una vez: es poder demostrar qué versión pasó, qué degradación se detectó y cómo el equipo recuperó el servicio sin ocultar incertidumbre.
Escrito por
Wasyra AI Systems
Confianza, copilots y adopción empresarial
Wasyra AI Systems cubre guardrails, modos sugerencia y diseño de revisión para que asistentes de trabajo generen adopción real.
Serie
Sistemas IA que sí llegan a producción
Una serie sobre agentes, copilots y guardrails para llevar IA al trabajo real sin romper confianza ni operación.
Posts de esta serieMás de este autor
Más de este autor
Sistemas IA
Modelo open-weight: cinco gates antes de alojarlo
Tener los pesos no equivale a controlar el sistema. Cinco gates para decidir si un modelo open-weight merece tu propia infraestructura.
ArtículoSistemas IA
Agentic Autofix: seis gates para aceptar un parche de seguridad
Cerrar una alerta no demuestra que el parche sea seguro. Este marco separa detección, remediación, regresión y decisión de merge.
ArtículoSigue leyendo
Sigue leyendo
Sistemas IA
Modelo open-weight: cinco gates antes de alojarlo
Tener los pesos no equivale a controlar el sistema. Cinco gates para decidir si un modelo open-weight merece tu propia infraestructura.
ArtículoSistemas IA
Agentic Autofix: seis gates para aceptar un parche de seguridad
Cerrar una alerta no demuestra que el parche sea seguro. Este marco separa detección, remediación, regresión y decisión de merge.
ArtículoSistemas IA
Políticas frescas para agentes: cuándo fallar cerrado
Una política central no protege si el cliente usa una copia vieja. Cinco gates convierten vigencia, precedencia y versión en evidencia.
Artículo