Políticas frescas para agentes: cuándo fallar cerrado
GitHub Copilot ahora puede exigir una descarga fresca de ajustes administrados al iniciar y bloquear operaciones cuando no logra confirmar la política. Esta guía traduce ese cambio en un contrato general para agentes: autoridad identificable, vigencia explícita, precedencia conservadora, clientes capaces y un modo de fallo ensayado.
- Publicado
- min de lectura
- 8 min de lectura
- Categoría
- Sistemas IA
En esta página
7 capítulos- 01¿Cuándo debe un agente fallar cerrado por política?
- 02¿Cómo pasa una política del repositorio a la ejecución?
- 03Cinco gates para aprobar políticas de agentes
- 04Ejemplo hipotético: revocar acceso de un agente a producción
- 05¿Cómo implementar frescura sin detener a toda la empresa?
- 06¿Qué debe medir una prueba de fail closed?
- 07Conclusión: la política efectiva necesita una prueba de vida
Capítulo 01
¿Cuándo debe un agente fallar cerrado por política?
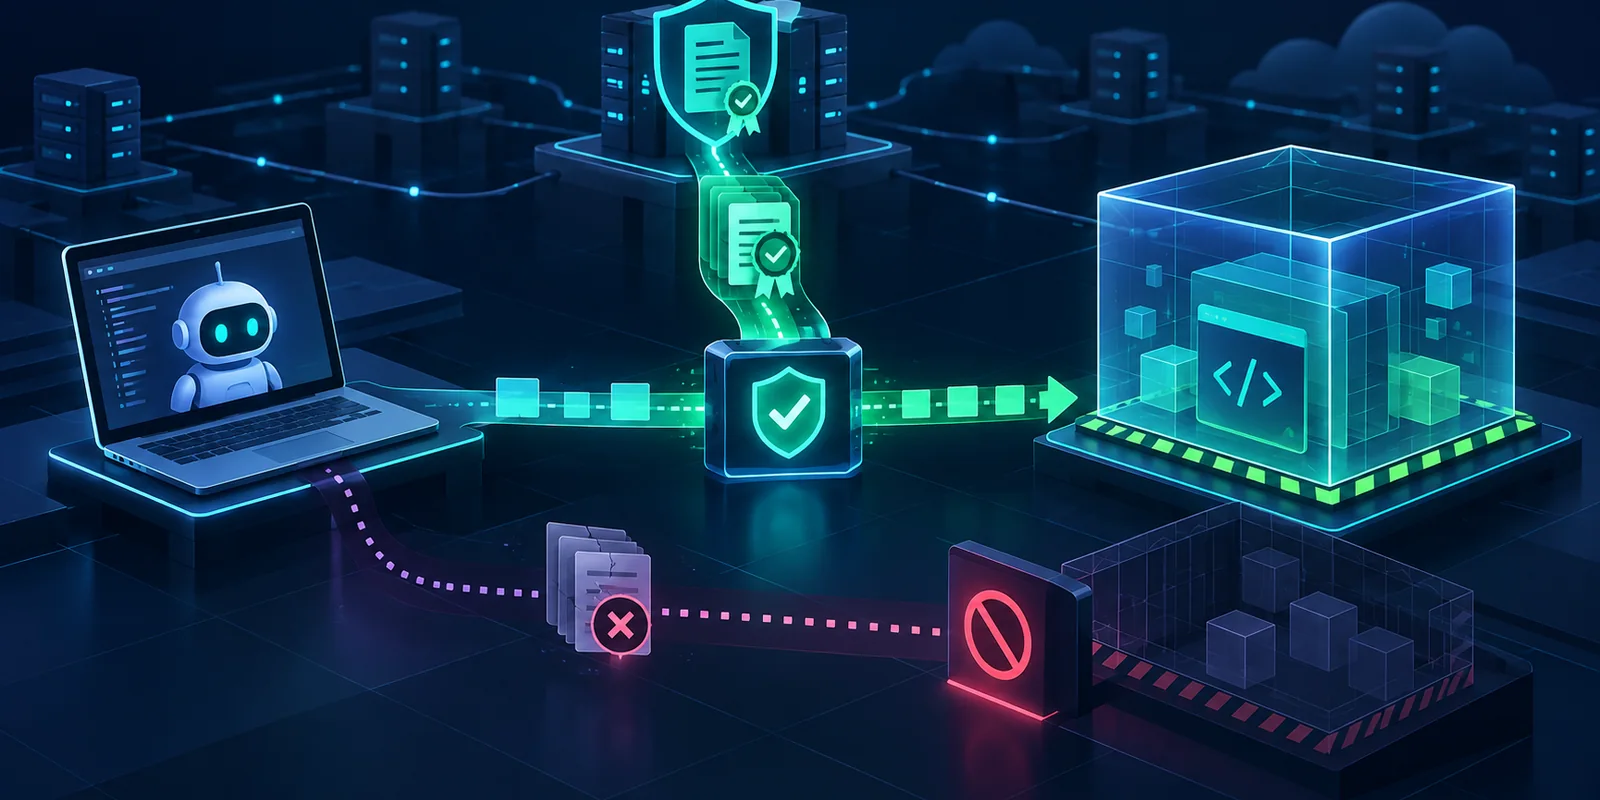
Un agente debe fallar cerrado cuando una acción depende de una política vigente y el cliente no puede demostrar que recibió, entendió y aplicó la versión autorizada. No basta con que exista un archivo central: la decisión efectiva ocurre en una combinación de usuario, dispositivo, cliente, versión, workspace y herramienta. Si esa combinación conserva una copia antigua, puede ejecutar con permisos que el administrador ya revocó. GitHub formalizó el problema el 13 de octubre de 2026 al permitir que Copilot CLI, VS Code y la app de Copilot exijan una descarga fresca de ajustes administrados. Con la exigencia activa, una respuesta cacheada no confirma la postura; si la descarga falla, las operaciones afectadas se restringen o las funciones quedan bloqueadas. Conviene para cambios urgentes —desactivar computer use, cerrar un dominio o endurecer el sandbox—, pero introduce dependencia de red y riesgo de indisponibilidad. La decisión correcta no es fallar cerrado siempre: es declarar qué controles no admiten una política vieja y probar cómo se recupera el trabajo sin abrir un bypass.
La noticia central tenía dos días calendario en America/Lima al consultarla el 15 de octubre. GitHub también anunció que la clave de sandbox puede exigir una versión mínima del cliente, de modo que un binario antiguo no continúe cuando carece de la semántica de enforcement requerida. Estas son afirmaciones de contrato del proveedor, no una medición independiente de disponibilidad, latencia ni resistencia frente a un cliente manipulado. El valor para otros sistemas de agentes está en el mecanismo: una política solo gobierna cuando puede probar autoridad, versión, vigencia, precedencia y respuesta ante fallo.
Capítulo 02
¿Cómo pasa una política del repositorio a la ejecución?
El flujo tiene cuatro estados, aunque muchas interfaces solo muestran «configurado». Primero, una autoridad publica una política con identidad y revisión: por ejemplo, un commit en un repositorio privado administrado, una carga de MDM o un archivo del sistema. Segundo, el cliente la obtiene y valida su formato. Tercero, combina fuentes según reglas de precedencia. Cuarto, el runtime traduce el resultado a decisiones sobre comandos, rutas, dominios, MCP, plugins, computer use o sandbox. La evidencia debe acompañar cada transición; de lo contrario, el dashboard solo prueba intención administrativa, no enforcement.
La frescura responde una pregunta distinta de la validez. Una copia puede tener JSON correcto y firma legítima, pero representar una decisión revocada. Por eso un contrato necesita identificador de versión, instante de emisión, instante de recepción, periodo máximo admitido y estado de confirmación. GitHub documenta que su descarga fresca evita usar el cache normal de una hora en CLI y la app; en VS Code bloquea funciones hasta que la actualización requerida tenga éxito. Una implementación propia puede usar ETag, hash o número monotónico, pero debe evitar depender solo del reloj local, que puede estar desajustado o alterado.
La precedencia evita que una fuente menos confiable suavice otra. La documentación de GitHub ordena MDM, servidor, archivo y preferencias del usuario, mientras compone sandbox y permisos en la dirección más restrictiva. Para permisos granulares usa deny antes que ask y ask antes que allow; cuando varias fuentes declaran allowlists, la autorización efectiva se comporta como intersección. El patrón general es importante: combinar políticas de seguridad como una unión de permisos crea escalamiento accidental. Cada clave debe declarar si reemplaza, intersecta, hereda o elige el valor más restrictivo.
Capítulo 03
Cinco gates para aprobar políticas de agentes
Trate la política como un protocolo distribuido, no como una pantalla de administración. Los cinco gates siguientes separan existencia de vigencia y convierten una promesa de control en un resultado comprobable.
| Gate | Pregunta de decisión | Evidencia de aceptación |
|---|---|---|
| 1. Autoridad | ¿Quién puede cambiar la política y cómo se revisa? | Identidad, historial, aprobación y rollback. |
| 2. Vigencia | ¿Qué antigüedad es tolerable para esta capacidad? | Revisión aplicada, hora de recepción y estado confirmado. |
| 3. Precedencia | ¿Puede una fuente inferior ampliar permisos? | Pruebas de conflicto con resultado conservador. |
| 4. Capacidad | ¿El cliente entiende y aplica la semántica requerida? | Versión mínima, matriz por cliente y prueba negativa. |
| 5. Fallo | ¿Qué ocurre sin red, autoridad o parser válido? | Bloqueo visible, recuperación ensayada y bypass controlado. |
Capítulo 04
Ejemplo hipotético: revocar acceso de un agente a producción
Imagine una empresa SaaS cuyo agente de soporte puede leer tickets, consultar logs y ejecutar consultas de diagnóstico de solo lectura. Una investigación revela que un conector incluye identificadores personales en los resultados. El equipo de seguridad elimina inmediatamente el dominio del conector de la allowlist y añade una regla deny. El cambio central se aprueba a las 10:00, pero veinte laptops conservan una copia descargada a las 9:35. Si el cache sigue siendo válido por una hora, la revocación administrativa y la capacidad real divergen durante 35 minutos.
En el piloto hipotético, las capacidades se clasifican por tolerancia. Navegar documentación pública admite una política cacheada durante una interrupción corta. Consultar datos internos exige una revisión no mayor de quince minutos. Acceder a producción exige confirmación fresca al inicio de la sesión y de nuevo antes de obtener credenciales efímeras. El runtime adjunta revisión de política, versión del cliente y decisión efectiva a cada tool call, sin copiar el contenido del ticket ni del resultado. Cuando la autoridad no responde, la lectura pública continúa y las herramientas de producción aparecen bloqueadas con una causa verificable.
La recuperación no consiste en pedir al usuario que desactive controles. La interfaz ofrece reintento, muestra la última revisión confirmada y enlaza el estado del servicio. Existe un procedimiento break-glass separado, con duración corta, aprobación de dos personas, alcance a una sola tarea y auditoría posterior. Al restablecer la autoridad, el cliente debe volver a descargar antes de salir del modo restringido. Este ejemplo no describe un cliente real de Wasyra ni un benchmark: ilustra cómo convertir la frescura en una propiedad por capacidad, en lugar de un interruptor global.
Capítulo 05
¿Cómo implementar frescura sin detener a toda la empresa?
Empiece por inventariar puntos de enforcement. Para cada cliente registre versión, fuente de política, claves soportadas, comportamiento sin red y dueño operativo. Separe controles de preferencia —modelo por defecto o apariencia— de controles de riesgo —computer use, permisos, dominios, sandbox, MCP y credenciales—. Solo los segundos necesitan una garantía fuerte. Si el proveedor exige una versión mínima para una clave, trátela como parte del rollout: primero mida cobertura, después bloquee versiones antiguas y finalmente active la exigencia de frescura.
Despliegue por cohortes. Una canary pequeña recibe la política nueva y ejecuta pruebas negativas: dominio prohibido, comando en deny, ruta fuera del sandbox, servidor MCP no permitido y descarga remota fallida. Observe tanto bypasses como falsos bloqueos. Luego amplíe a un equipo con soporte disponible y finalmente al resto. Mantenga un kill switch del lado de la autoridad, pero no permita que el mismo canal que publica la política desactive silenciosamente la verificación; el control de emergencia necesita identidad y registro propios.
Diseñe la experiencia de fallo. El usuario debe distinguir «la herramienta está caída» de «la política no pudo confirmarse» y saber qué trabajo local sigue permitido. Evite retry loops que saturen la autoridad; use backoff, estado explícito y métricas sin contenido para tasa de refresh, antigüedad, errores por cliente y tiempo de recuperación. Una política fresca que nadie puede diagnosticar genera bypasses informales; una explicación acotada reduce esa presión sin revelar reglas sensibles completas.
Capítulo 06
¿Qué debe medir una prueba de fail closed?
Evalúe seguridad y disponibilidad por separado. Para seguridad, intente operar con revisión vieja, fuente inferior permisiva, archivo mal formado, cliente sin soporte y reloj local alterado. La aceptación exige que una capacidad protegida no se ejecute y que el evento deje revisión esperada, revisión observada, cliente y motivo, sin capturar secretos. Para disponibilidad, mida cuánto trabajo seguro permanece, cuánto tarda la recuperación y cuántos usuarios intentan bypass. Un sistema puede bloquear correctamente y aun ser inviable si una interrupción de la autoridad paraliza tareas que no necesitaban ese control.
Incluya pruebas de transición, no solo estados estables. Cambie allow a deny durante una sesión activa; rote la autoridad; reduzca la versión mínima; restaure la red después de varios fallos; y retire una excepción break-glass. Verifique que las sesiones nuevas y existentes adoptan la semántica declarada, que la recuperación no reutiliza un cache inválido y que una fuente menos prioritaria no reabre la capacidad. Si distintos clientes reaccionan diferente, documente la diferencia como parte del producto, no como una nota de implementación.
- No confunda «la política se publicó» con «cada runtime confirmó la revisión».
- No use una allowlist unida entre fuentes cuando la intención era que todas aprobaran.
- No active fail closed sin ruta visible de diagnóstico y recuperación.
- No trate una versión mínima como inventario; pruébela intentando ejecutar desde un cliente antiguo.
- No permita que break-glass se convierta en una preferencia persistente.
Capítulo 07
Conclusión: la política efectiva necesita una prueba de vida
La novedad no es otro archivo de configuración; es reconocer que el cache forma parte de la frontera de seguridad. Los cinco gates —autoridad, vigencia, precedencia, capacidad y fallo— obligan a seguir la política hasta el runtime que decide. Falla cerrado solo para capacidades cuyo riesgo supera el costo de indisponibilidad, conserva trabajo seguro cuando sea posible y ensaya la recuperación antes de una revocación real.
Si necesitas diseñar un piloto con herramientas, permisos, sandbox, trazas y gates de release, el servicio de agentes a medida de Wasyra puede convertir estas reglas en pruebas operativas. Es un servicio de implementación en wasyra.com, separado del producto Agents disponible en agents.wasyra.com. El resultado que importa no es una consola administrada: es poder demostrar qué política gobernó cada acción.
Escrito por
Wasyra AI Systems
Confianza, copilots y adopción empresarial
Wasyra AI Systems cubre guardrails, modos sugerencia y diseño de revisión para que asistentes de trabajo generen adopción real.
Serie
Sistemas IA que sí llegan a producción
Una serie sobre agentes, copilots y guardrails para llevar IA al trabajo real sin romper confianza ni operación.
Posts de esta serieMás de este autor
Más de este autor
Sistemas IA
Telemetría de agentes: observar sin capturar secretos
Atribuir actividad no exige copiar prompts ni código. Cinco decisiones ayudan a diseñar telemetría útil, mínima y auditable.
ArtículoSistemas IA
ReplaySSM: cómo evaluar inferencia híbrida
Checkpoint, buffer y precisiones separadas prometen acelerar modelos híbridos. Seis decisiones muestran cuándo el mecanismo encaja.
ArtículoSigue leyendo
Sigue leyendo
Sistemas IA
Telemetría de agentes: observar sin capturar secretos
Atribuir actividad no exige copiar prompts ni código. Cinco decisiones ayudan a diseñar telemetría útil, mínima y auditable.
ArtículoSistemas IA
ReplaySSM: cómo evaluar inferencia híbrida
Checkpoint, buffer y precisiones separadas prometen acelerar modelos híbridos. Seis decisiones muestran cuándo el mecanismo encaja.
ArtículoSistemas IA
Clústeres GPU: cómo repartir capacidad sin inflar prioridades
Presupuestos de tiempo, fair-share y contratos de ejecución convierten una cola GPU disputada en una decisión operativa verificable.
Artículo