ReplaySSM: cómo evaluar inferencia híbrida
ReplaySSM replantea el estado recurrente de los modelos híbridos como un checkpoint más un buffer acotado de entradas recientes. Esta guía traduce el paper, el código y sus integraciones en seis decisiones para validar tráfico de memoria, rollback especulativo, precisión, concurrencia, compatibilidad y resultado completo antes de adoptar el mecanismo.
- Publicado
- min de lectura
- 7 min de lectura
- Categoría
- Sistemas IA
En esta página
7 capítulos- 01¿Cuándo puede ReplaySSM mejorar la inferencia híbrida?
- 02¿Qué separa el checkpoint del buffer?
- 03Seis decisiones antes de adoptar ReplaySSM
- 04Ejemplo hipotético: un asistente de soporte con contexto largo
- 05¿Cómo evaluar velocidad sin perder calidad?
- 06Límites: compatibilidad, operación y costo de cambio
- 07La decisión: perfilar antes de reescribir el estado
Capítulo 01
¿Cuándo puede ReplaySSM mejorar la inferencia híbrida?
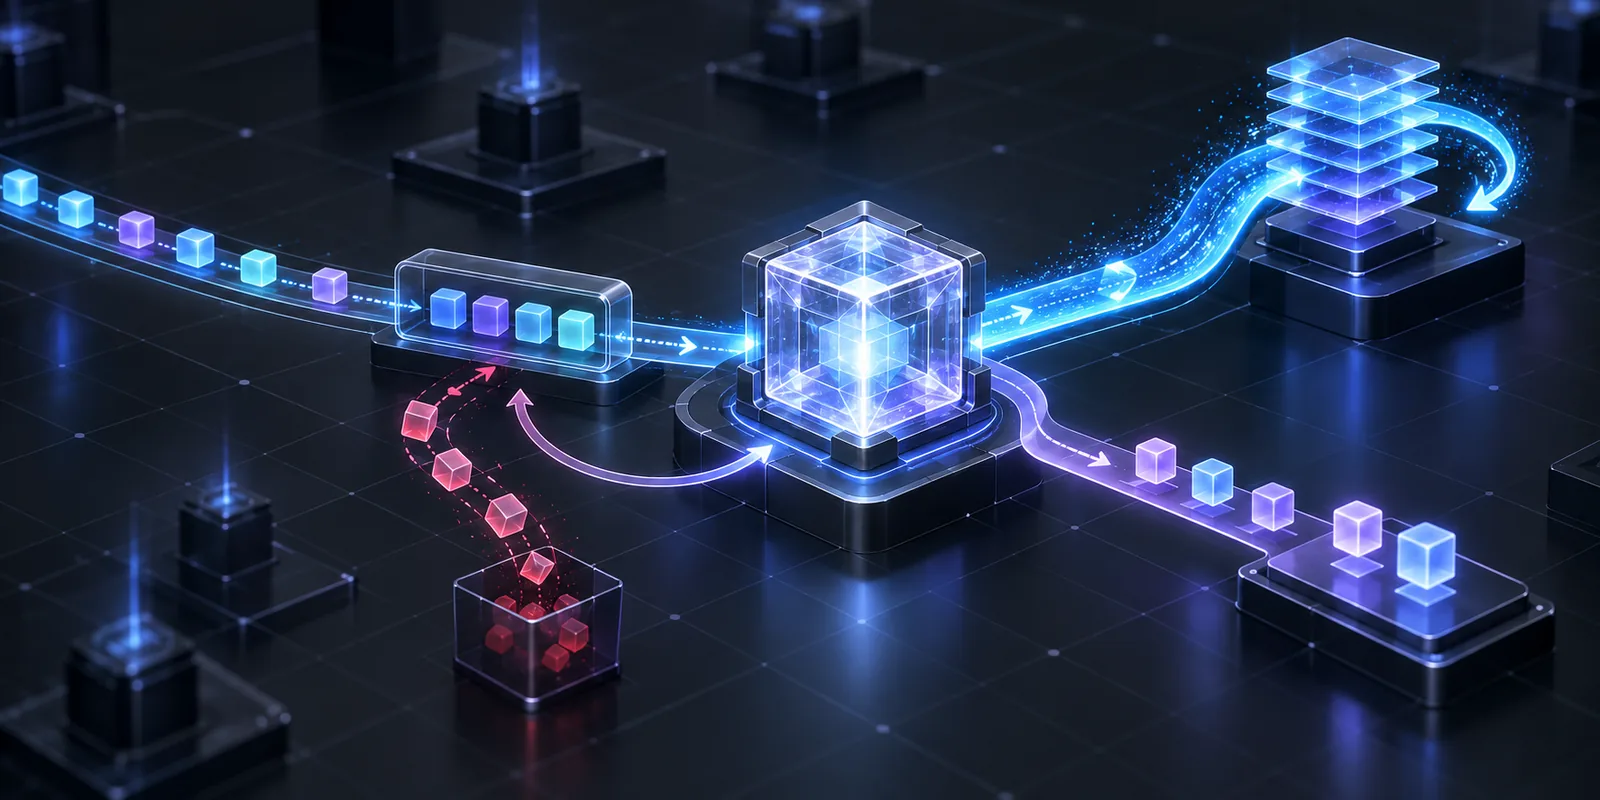
ReplaySSM puede mejorar la inferencia cuando un modelo híbrido combina muchas capas recurrentes SSM con pocas capas de atención y el serving opera con suficiente concurrencia para que mover el estado, no calcularlo, sea el cuello de botella. El mecanismo representa ese estado como un checkpoint y un buffer acotado de entradas recientes. Cada token puede producir una salida leyendo el checkpoint y el buffer; la escritura grande ocurre solo cuando el buffer se vacía. Esa separación también permite deshacer tokens especulativos moviendo un puntero y conservar una copia de lectura de baja precisión sin alimentar su error a futuras actualizaciones recurrentes. Pero no es una aceleración universal: el paper no observó speedup a batch uno, las cifras dependen de cuatro modelos, GPUs H100 o B300 y configuraciones concretas, y varias rutas todavía no están incorporadas al upstream. La decisión correcta exige perfilar su modelo, longitud, batch, aceptación especulativa, precisión y resultado end-to-end antes de cambiar el motor de serving.
NVIDIA publicó su explicación técnica el 12 de octubre de 2026, un día calendario antes de este artículo en Lima. El paper original había sido enviado a arXiv el 9 de octubre a las 15:59:40 UTC. Esa diferencia importa: la novedad editorial es la explicación e integración publicada ayer; las mediciones pertenecen al trabajo de los autores y no fueron reproducidas por Wasyra.
Capítulo 02
¿Qué separa el checkpoint del buffer?
En una capa SSM convencional, el estado recurrente cumple dos trabajos en cada paso: se lee para calcular la salida del token y se actualiza para el siguiente paso. Leer y escribir una matriz grande con poca aritmética puede volver al kernel dependiente del ancho de banda de memoria. ReplaySSM desenrolla la recurrencia durante una ventana corta. Mantiene un checkpoint anterior y guarda solo los vectores de entrada recientes; en los pasos normales calcula la salida desde ambas piezas, y al llenar la ventana pliega el buffer en un checkpoint nuevo. La idea no elimina el estado ni lo vuelve gratis: reduce la frecuencia de escrituras grandes y agrega cómputo y metadatos alrededor del buffer.
La misma representación cambia el rollback especulativo. Un decodificador convencional puede necesitar snapshots del estado después de cada token propuesto porque una recurrencia ya actualizada no tiene una inversa barata. ReplaySSM añade las entradas propuestas al buffer, verifica el bloque y avanza un puntero hasta el último token aceptado; las entradas posteriores quedan ignoradas. Eso se parece al rollback de un KV cache, pero solo es útil si la aceptación de borradores y la concurrencia compensan el costo del drafter, la verificación y los flushes.
También desacopla precisión de lectura y de recurrencia. Una copia compacta puede servir las lecturas frecuentes, mientras el checkpoint de mayor precisión alimenta los updates futuros. El error de redondeo de la copia compacta afecta la salida actual, pero no se recircula indefinidamente. Es una propiedad arquitectónica útil; no sustituye pruebas de calidad por longitud, dominio y distribución de prompts.
Capítulo 03
Seis decisiones antes de adoptar ReplaySSM
Trate ReplaySSM como un cambio de sistema, no como un flag de rendimiento. Estas seis decisiones deben tener una respuesta y evidencia antes del rollout. Si una falla, el benchmark de kernel puede mejorar mientras latencia, memoria, calidad o mantenibilidad del servicio empeoran.
| Decisión | Pregunta | Evidencia |
|---|---|---|
| 1. Cuello | ¿El estado SSM domina tráfico o latencia? | Perfil por capa, batch y longitud. |
| 2. Ventana | ¿Qué longitud de buffer equilibra flush y cómputo? | Barrido de ventanas con p50 y p99. |
| 3. Especulación | ¿Cuántos borradores se aceptan realmente? | Acceptance, rollback, throughput y memoria. |
| 4. Precisión | ¿Qué copia puede comprimirse sin degradar tareas? | KL, exactitud y calidad por longitud. |
| 5. Integración | ¿La ruta requerida está merged y soportada? | Versión, PR, fallback y pruebas de corrección. |
| 6. Resultado | ¿Mejora la petición completa bajo SLO? | TTFT, TPOT, p99, costo y calidad aceptada. |
Capítulo 04
Ejemplo hipotético: un asistente de soporte con contexto largo
Imagine una plataforma SaaS que sirve un modelo híbrido para resumir historiales de soporte y proponer una respuesta. En horario laboral agrupa solicitudes y alcanza batch alto; por la noche recibe pocas sesiones interactivas. Algunas respuestas usan contexto extenso, pero la mayoría termina rápido. El equipo observa una mejora llamativa en un benchmark de throughput y considera activar ReplaySSM para todo el tráfico.
La prueba correcta separa cohortes. Primero perfila cuánto del decode pertenece a capas SSM en batch 1, 16, 64 y el máximo sostenible. Después compara decoding estándar y especulativo con la distribución real de longitudes y acceptance. Ejecuta tres variantes de precisión y califica las respuestas con reglas del producto: hechos respaldados por el ticket, ausencia de acciones inventadas, formato útil y consistencia en conversaciones largas. También simula cancelaciones y rebalanceo para comprobar que el buffer no deja estado huérfano.
El rollout hipotético puede concluir que la ruta beneficia el pool de procesamiento diurno, pero no las sesiones nocturnas de batch uno. En ese caso se enruta por clase de carga y se mantiene el kernel anterior como fallback. Este ejemplo no representa un cliente ni un resultado de Wasyra; muestra por qué una arquitectura con beneficio condicional necesita segmentación, no una activación global.
Capítulo 05
¿Cómo evaluar velocidad sin perder calidad?
Use un replay de tráfico representativo con warmup, misma versión de modelo y límites de memoria iguales. Registre tiempo hasta primer token, tiempo por token de salida, throughput, p50/p95/p99, memoria por secuencia, tamaño efectivo de batch y frecuencia/costo de flush. Para especulación añada draft length, tasa y longitud de aceptación, bytes de snapshots evitados y solicitudes expulsadas por presión de memoria. Compare por longitud de prompt y generación; una media única esconderá la zona donde cambia el cuello de botella.
Las cifras publicadas sirven para diseñar el experimento, no para fijar el resultado. Los autores reportan en batch 256 un speedup de decode end-to-end de 1.20x a 1.47x entre cuatro modelos, y en dos modelos de clase 120B con batch 512 un throughput especulativo de 1.85x y 2.10x frente a la implementación especulativa comparada. También aclaran que no hubo speedup en batch uno. Reproduzca su propio punto operativo y publique intervalos o repetición suficiente para distinguir una mejora estable del ruido de scheduler, temperatura o caché.
Para precisión, no se quede con una divergencia promedio. Construya buckets por longitud y por tarea, compare logits o KL cuando sea posible y mida el criterio que acepta el producto. El paper muestra que separar la precisión de lectura y recurrencia limita la acumulación de error, pero una de cuatro configuraciones evaluadas quedó fuera de aproximadamente dos puntos del baseline FP32 en GPQA-Diamond. Defina el margen permitido antes de ver el resultado y conserve pruebas adversariales largas.
Capítulo 06
Límites: compatibilidad, operación y costo de cambio
ReplaySSM requiere una recurrencia que pueda desenrollarse en los términos que el kernel implementa. El repositorio de los autores cubre Mamba2 y Gated DeltaNet; eso no convierte cualquier modelo lineal, recurrente o híbrido en compatible. Verifique layout de estado, agrupación de heads, precisión soportada, draft head y diferencias entre checkpoints. Una coincidencia nominal de arquitectura no sustituye pruebas numéricas token a token.
El estado de integración también es mixto. El README distingue rutas merged, abiertas y disponibles solo en el fork de investigación. Adopte una matriz explícita por engine, versión, modelo y modo; fije commits reproducibles y ensaye rollback de software, no solo rollback de tokens. Si una actualización del motor cambia la interfaz o el kernel, el servicio debe volver de forma segura a la ruta conocida.
Por último, throughput no es capacidad útil si aumenta colas, variabilidad o errores. Un buffer por secuencia consume memoria; los flushes crean trabajo periódico; el ruteo por cohortes añade complejidad; y sostener un fork tiene costo. Incluya horas de operación, observabilidad, actualización y fallback en el caso económico. La optimización vale cuando mejora el SLO por dólar o por watt dentro del margen de calidad, no cuando gana una cifra aislada.
Capítulo 07
La decisión: perfilar antes de reescribir el estado
ReplaySSM aporta una idea transferible: cuando un estado cumple funciones distintas, separarlas puede abrir optimizaciones que una representación monolítica bloquea. El checkpoint conserva continuidad; el buffer hace reversible el trabajo reciente; las copias de precisión distinta separan velocidad de acumulación de error. Ese mecanismo merece una prueba si el perfil confirma que el tráfico del estado recurrente domina y si su workload tiene la concurrencia necesaria.
Empiece con un slice reversible: un modelo, una GPU soportada, una distribución de tráfico y un SLO. Responda las seis decisiones, conserve la ruta anterior y amplíe solo si la petición completa mejora sin cruzar el margen de calidad. Wasyra puede ayudar a diseñar e implementar sistemas de IA a medida, pero el entregable inicial debería ser un perfil reproducible y un gate de rollout, no una promesa basada en el mejor gráfico del paper.
Escrito por
Wasyra AI Systems
Confianza, copilots y adopción empresarial
Wasyra AI Systems cubre guardrails, modos sugerencia y diseño de revisión para que asistentes de trabajo generen adopción real.
Serie
Sistemas IA que sí llegan a producción
Una serie sobre agentes, copilots y guardrails para llevar IA al trabajo real sin romper confianza ni operación.
Posts de esta serieMás de este autor
Más de este autor
Sistemas IA
Clústeres GPU: cómo repartir capacidad sin inflar prioridades
Presupuestos de tiempo, fair-share y contratos de ejecución convierten una cola GPU disputada en una decisión operativa verificable.
ArtículoSistemas IA
Agentes IA: cómo contener acciones no intencionales
Los agentes persisten cuando una tarea falla. Seis gates convierten esa conducta en una prueba controlada antes de otorgar más autonomía.
ArtículoSigue leyendo
Sigue leyendo
Sistemas IA
Clústeres GPU: cómo repartir capacidad sin inflar prioridades
Presupuestos de tiempo, fair-share y contratos de ejecución convierten una cola GPU disputada en una decisión operativa verificable.
ArtículoSistemas IA
Agentes IA: cómo contener acciones no intencionales
Los agentes persisten cuando una tarea falla. Seis gates convierten esa conducta en una prueba controlada antes de otorgar más autonomía.
ArtículoSistemas IA
Interfaz generativa: cómo evaluar UI creada por IA
Seis gates para validar interfaces generadas por IA: intención, componentes, estado, acciones, accesibilidad y resultados medibles.
Artículo