Agentes distribuidos: cuándo paralelizar el análisis
OpenAI, PerturbAI y Scripps publicaron un análisis biológico con miles de agentes en paralelo. Esta guía separa el resultado científico del patrón de ingeniería: unidades independientes, contratos de evidencia, síntesis trazable, deduplicación, presupuesto y evaluación contra un agente único antes de escalar.
- Publicado
- min de lectura
- 7 min de lectura
- Categoría
- Sistemas IA
En esta página
7 capítulos- 01¿Cuándo conviene distribuir un análisis entre agentes?
- 02Cómo funciona el patrón fan-out y fan-in
- 03Ejemplo hipotético: revisar miles de proveedores
- 04Siete decisiones antes de multiplicar agentes
- 05¿Cómo se evalúa un sistema de agentes distribuidos?
- 06Qué no demuestra el estudio
- 07La decisión: escalar evidencia, no cantidad de agentes
Capítulo 01
¿Cuándo conviene distribuir un análisis entre agentes?
Conviene cuando el trabajo puede dividirse en unidades independientes, cada unidad produce evidencia verificable, una etapa separada puede sintetizar sin borrar desacuerdos ni procedencia y una línea base demuestra que el agente único pierde cobertura.
El 21 de octubre de 2026, OpenAI, PerturbAI y Scripps Research publicaron cómo asignaron miles de agentes a perturbaciones individuales de un atlas CRISPR del cerebro de ratón. El anuncio, consultado el 22 de octubre en America/Lima, tiene un día de antigüedad; el preprint original es del 16 de octubre. Según las fuentes primarias, los agentes analizaron datos de millones de células en 32 minutos, conectaron respuestas celulares con literatura y produjeron un atlas de razonamiento. En la carga más grande, la configuración distribuida citó más de 700 referencias frente a 11 del agente único, y expertos ciegos prefirieron sus interpretaciones el 75% de las veces.
Eso demuestra un resultado en un estudio concreto, no una ley universal de que más agentes sean mejores. La decisión útil para un CTO es más estrecha: si su problema contiene muchas unidades comparables que un solo contexto explora de forma superficial, el paralelismo puede comprar cobertura. Pero si las unidades comparten estado mutable, dependen de decisiones anteriores o no dejan evidencia estructurada, multiplicar workers también multiplica costo, contradicciones y fallos difíciles de reproducir. El patrón merece un piloto cuando cobertura y trazabilidad son el cuello de botella; no cuando la tarea exige una sola secuencia coherente de decisiones.
Capítulo 02
Cómo funciona el patrón fan-out y fan-in
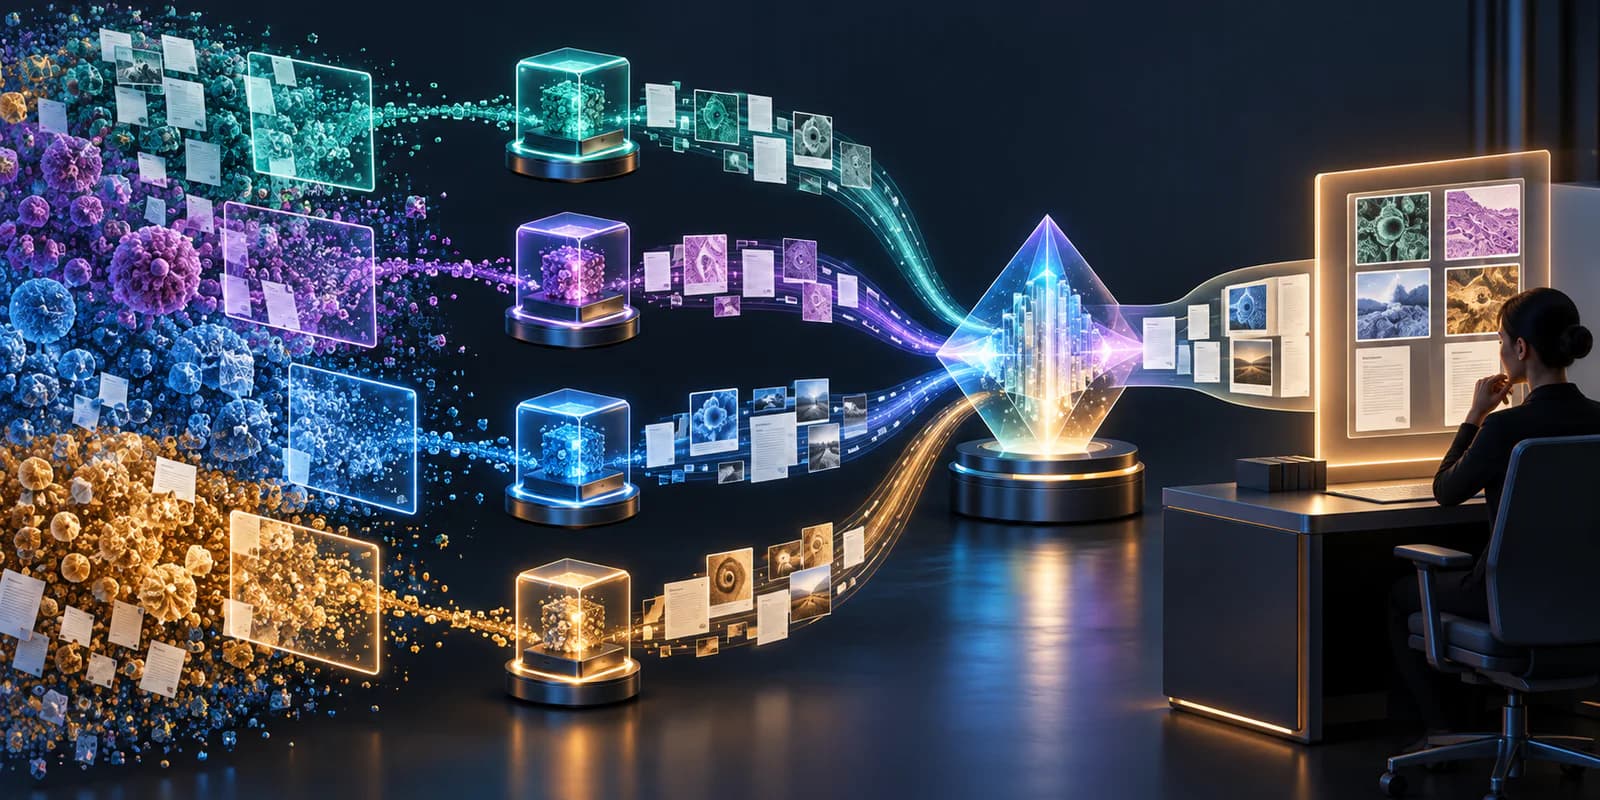
El mecanismo tiene tres contratos. Primero, un planificador convierte un objetivo amplio en una colección de unidades con el mismo esquema. En el estudio, cada unidad correspondía a una perturbación genética y el worker combinaba datos de expresión, contexto celular y búsqueda de literatura. Segundo, cada worker entrega un artefacto durable: hallazgos narrativos, afirmaciones estructuradas, citas y mediciones. El repositorio público conserva runtime, herramientas del corpus, prompts, reportes guardados y notebooks de análisis; esa persistencia permite revisar el resultado sin volver a inferirlo.
Tercero, un sintetizador opera sobre esos artefactos, no sobre recuerdos de una conversación gigante. Debe agrupar señales repetidas, conservar conclusiones opuestas, ponderar calidad de evidencia y enlazar cada resumen con sus unidades de origen. El valor del fan-out es ampliar la superficie investigada; el valor del fan-in es convertir esa amplitud en una salida navegable. Si el sintetizador solo concatena prosa, crea volumen. Si resume sin IDs estables, elimina la posibilidad de auditar. Y si vuelve a consultar el dato original sin registrar cambios, introduce una segunda ruta de análisis que ya no coincide con los workers.
| Etapa | Contrato | Fallo que debe verse |
|---|---|---|
| Partición | Unidades completas, independientes y versionadas | Unidad omitida, solapada o dependiente |
| Worker | Claims, evidencia, citas y estado explícito | Timeout, evidencia insuficiente o conflicto |
| Síntesis | Resumen trazable a unidades y fuentes | Duplicado, contradicción o procedencia perdida |
Capítulo 03
Ejemplo hipotético: revisar miles de proveedores
Imagina una empresa que debe revisar 4.000 proveedores antes de renovar contratos. Este ejemplo es hipotético. Cada unidad contiene el contrato vigente, el expediente de seguridad, incidentes, certificaciones y restricciones regionales de un proveedor. Un worker puede comparar ese paquete con una rúbrica común y producir claims como «certificación vencida», «cláusula de subprocesadores ausente» o «evidencia contradictoria», siempre con archivo, página, fecha y fragmento. Las unidades son paralelizables porque evaluar al proveedor A no debe modificar el expediente del proveedor B.
El sintetizador no debería decidir automáticamente qué contratos cancelar. Puede agrupar proveedores por riesgo, señalar patrones y priorizar expedientes para revisión humana. Las acciones con impacto permanecen en otro sistema y requieren autorización. Si dos workers citan versiones distintas del mismo certificado, la síntesis conserva el conflicto en vez de escoger la prosa más convincente. Si una unidad falla por permisos o formato, aparece como incompleta y no como «sin hallazgos». Así, el paralelismo amplía cobertura sin convertir ausencia de análisis en ausencia de riesgo.
Capítulo 04
Siete decisiones antes de multiplicar agentes
La cantidad de workers es un parámetro posterior. Primero hay que fijar qué significa una unidad correcta, una síntesis aceptable y un fallo visible.
La primera decisión es la frontera de partición: cada unidad debe caber en contexto, tener inputs completos y evitar estado compartido. La segunda es el contrato de evidencia: claims tipados, citas resolubles, versión de fuente y nivel de confianza, no solo un informe libre. La tercera es idempotencia: reintentar una unidad no puede crear resultados duplicados ni cambiar su identidad. La cuarta es el algoritmo de síntesis: reglas explícitas para deduplicar, agrupar y conservar desacuerdo. Sin esas cuatro, un resultado grande puede parecer exhaustivo aunque combine huecos, réplicas y conclusiones incompatibles.
La quinta decisión es presupuesto: límites por unidad, por lote y por resultado útil, con cancelación cuando la evidencia marginal deja de justificar costo y latencia. La sexta es aislamiento: datasets autorizados, herramientas de solo lectura cuando corresponda, credenciales por trabajo y ninguna capacidad heredada por conveniencia. La séptima es evaluación comparativa: misma tarea, mismas fuentes y mismo presupuesto total para el agente único y la variante distribuida. El anuncio reciente fijó modelo y recursos al comparar configuraciones; un piloto empresarial debe aplicar el mismo principio y cambiar una variable por vez.
- 1. Partición con unidades independientes y completas.
- 2. Contrato estructurado de claims y evidencia.
- 3. Identidad e idempotencia para reintentos seguros.
- 4. Síntesis que deduplica sin borrar desacuerdos.
- 5. Presupuesto y criterio de parada por valor marginal.
- 6. Permisos y herramientas aislados por trabajo.
- 7. Comparación controlada contra una línea base única.
Capítulo 05
¿Cómo se evalúa un sistema de agentes distribuidos?
Empieza con casos dorados estratificados, no con una demo favorable. Incluye lotes pequeños y grandes, evidencia abundante y escasa, unidades con formatos rotos, fuentes contradictorias y respuestas que deben abstenerse. Mide cobertura de unidades, proporción completada, recall de evidencia, precisión de claims, citas resolubles, duplicados, contradicciones preservadas y utilidad del ranking final. Separa error del worker, error de herramienta y error de síntesis; una métrica end-to-end indica si el sistema sirve, pero no dice qué componente reparar.
Después compara bajo tres presupuestos equivalentes: tiempo de pared, tokens o costo monetario. El paralelismo puede reducir latencia de pared mientras aumenta cómputo total, por lo que reportar solo minutos oculta la economía. Observa p50 y p95 por unidad, cola, reintentos, tasa de throttling, costo por claim aceptado y costo por caso que cambia una decisión humana. Revisa manualmente una muestra ciega del agente único y del distribuido. La preferencia humana del estudio es evidencia pertinente, pero no sustituye jueces del dominio, rubricas y distribución de trabajo propios.
Capítulo 06
Qué no demuestra el estudio
El trabajo es un preprint, no una publicación revisada por pares. Evalúa un atlas biológico, un conjunto de herramientas y un diseño de agentes concretos; no prueba que el patrón mejore cualquier tarea jurídica, financiera o de software. La cifra de 32 minutos describe ese despliegue y no informa por sí sola el costo total, la capacidad reservada ni el rendimiento bajo cuotas empresariales. Más referencias tampoco equivalen automáticamente a mejores conclusiones: pueden repetir una fuente, citar evidencia débil o aumentar el trabajo de revisión.
También hay riesgos sistémicos. Miles de workers pueden compartir el mismo sesgo del modelo, la misma fuente equivocada o una rúbrica mal definida, generando consenso aparente. La síntesis puede favorecer claims frecuentes sobre excepciones importantes. Una credencial demasiado amplia convierte un error de partición en exposición masiva. Y un lote que reintenta sin control puede producir una tormenta de costos. Por eso el sistema necesita diversidad de evidencia, muestreo adversarial, límites de concurrencia, circuit breakers, trazas agregadas y revisión humana enfocada en discrepancias e impactos altos.
Capítulo 07
La decisión: escalar evidencia, no cantidad de agentes
Aprueba un piloto si puedes nombrar la unidad de trabajo, verificar su evidencia y explicar por qué un solo agente pierde cobertura al crecer la carga. Empieza con decenas de unidades, no miles. Congela fuentes y rúbrica, ejecuta la línea base única, prueba fan-out con un límite de concurrencia pequeño y revisa el fan-in como producto independiente. Escala solo cuando la mejora de cobertura sobrevive a un presupuesto comparable, las citas siguen siendo resolubles y los fallos incompletos permanecen visibles.
La noticia reciente aporta una señal importante: para cargas naturalmente separables, distribuir contexto puede preservar profundidad donde un único agente comprime la búsqueda. La ventaja no proviene del número en sí, sino del contrato que convierte cada investigación en un artefacto auditable. Si necesitas diseñar la partición, los permisos, el esquema de evidencia y el harness de evaluación para un proceso real, el servicio de agentes a medida de Wasyra puede convertir esta arquitectura en un piloto medible. Ese servicio vive en wasyra.com y es distinto del producto Agents alojado en agents.wasyra.com.
Escrito por
Wasyra Lab
Arquitectura de sistemas IA y operaciones
Wasyra Lab publica marcos prácticos para diseñar agentes de IA, automatizaciones y flujos operativos que sí sobreviven producción.
Serie
Sistemas IA que sí llegan a producción
Una serie sobre agentes, copilots y guardrails para llevar IA al trabajo real sin romper confianza ni operación.
Posts de esta serieMás de este autor
Más de este autor
Sistemas IA
RAG multimodal: siete gates para confiar en la evidencia
Parsear, recuperar y reordenar son contratos distintos. Siete gates ayudan a decidir si una pila multimodal mejora la evidencia sin ocultar nuevos fallos.
ArtículoSistemas IA
AI software factory para startups: cómo lanzar producto sin inflar equipo
Cómo usar una software factory con IA para validar, construir y operar productos SaaS con menos equipo interno y más evidencia.
ArtículoSigue leyendo
Sigue leyendo
Sistemas IA
RAG multimodal: siete gates para confiar en la evidencia
Parsear, recuperar y reordenar son contratos distintos. Siete gates ayudan a decidir si una pila multimodal mejora la evidencia sin ocultar nuevos fallos.
ArtículoSistemas IA
Datos sintéticos multilingües: seis gates
Traducir millones de documentos no crea un corpus confiable. Seis gates separan generación, aceptación, evaluación y release multilingüe.
ArtículoSistemas IA
Evaluación continua de agentes: nueve gates
Un agente puede responder rápido y estar equivocado. Nueve gates conectan evaluación offline, release, producción y aprendizaje verificable.
Artículo