RAG multimodal: siete gates para confiar en la evidencia
NVIDIA publicó modelos abiertos separados para parsear documentos, recuperar texto e imágenes y reordenar candidatos. Esta guía traduce el avance en una arquitectura evaluable: contratos por etapa, métricas de recuperación, trazabilidad a la página original, pruebas de dominio, presupuesto de latencia y una comparación end-to-end antes de cambiar producción.
- Publicado
- min de lectura
- 7 min de lectura
- Categoría
- Sistemas IA
En esta página
6 capítulos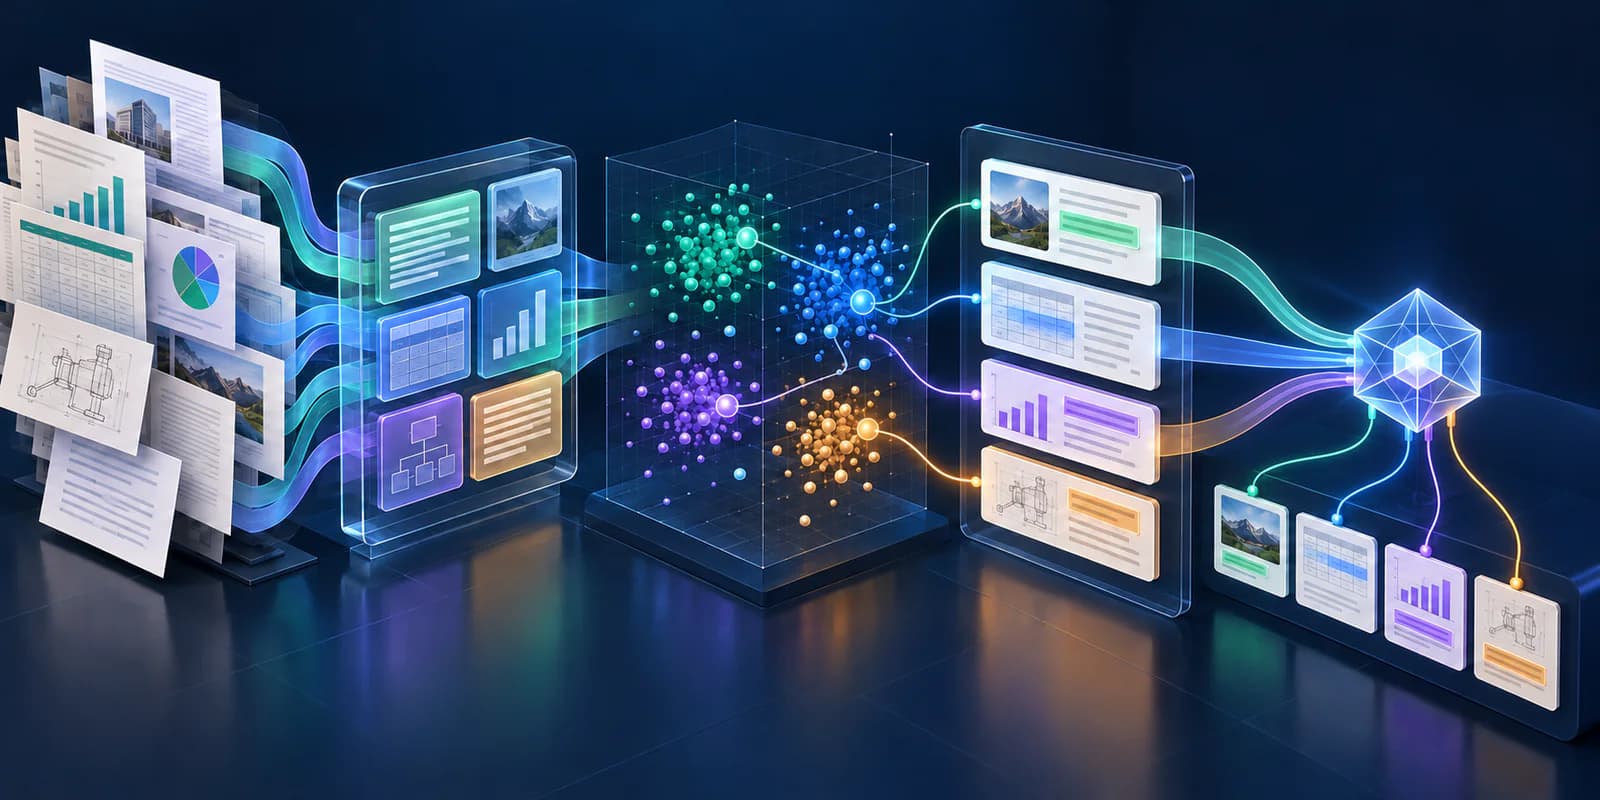
Capítulo 01
¿Cuándo está lista una recuperación multimodal?
Está lista cuando cada etapa puede fallar, medirse y sustituirse por separado, y cuando la respuesta conserva una ruta verificable hasta la región exacta del documento.
El 21 de octubre de 2026, NVIDIA presentó la familia Nemotron 3.5 Retriever: modelos distintos para convertir páginas en estructura, recuperar candidatos sobre texto e imágenes y reordenarlos antes de entregar evidencia a un agente. La página del anuncio fue publicada el mismo día de esta consulta en America/Lima; las fichas primarias fechan los pesos Embed y Rerank el 20 de octubre y Parse el 17. La novedad importante no es sumar otro modelo a una lista. Es hacer explícito que una tabla mal extraída, una página que nunca entró al conjunto candidato y un candidato relevante que quedó demasiado abajo son fallos diferentes y necesitan diagnósticos diferentes.
Esa separación importa porque un modelo generativo solo puede razonar sobre la evidencia que recibe. Si la tubería borra encabezados, mezcla el orden de lectura o recupera una página visualmente parecida pero semánticamente incorrecta, pedirle un modelo final más grande no repara el contrato roto. Para un CTO, la decisión útil es si una pila por etapas aumenta la recuperación de evidencia relevante en sus documentos reales, con latencia y costo aceptables, sin perder procedencia. Un benchmark público puede justificar una prueba; no autoriza el cambio de producción.
Capítulo 02
Tres contratos, no una caja RAG
Parsear responde qué hay en la página y dónde está. Un parser útil no se limita a producir texto: conserva clases de layout, cajas, orden de lectura y estructura de tablas o gráficos para que un fragmento pueda volver a su fuente. Nemotron 3.5 Parse declara precisamente esas salidas y ofrece modos de una, dos y tres pasadas. NVIDIA reporta un intercambio explícito en su hardware de referencia: más pasadas elevan el score de ParseBench y reducen páginas por segundo. La lección general es valiosa aun si se elige otro parser: la precisión de regiones complejas debe ser una política por tipo de documento, no un modo global aplicado a todo el archivo.
Recuperar y reordenar tienen otro contrato. El embedding codifica consultas y documentos por separado para encontrar un conjunto amplio de candidatos con rapidez. El reranker evalúa cada par consulta-documento con más detalle y cambia el orden final. En el anuncio, NVIDIA mantiene fijo el agente, las herramientas, las tareas, el corpus y la política de ejecución, y cambia la configuración de recuperación; bajo ese montaje reporta que añadir Rerank redujo aproximadamente 13–14% los tokens del agente por consulta y mejoró la precisión de recuperación. Ese es un resultado del experimento publicado, no una promesa para cualquier corpus. En producción hay que repetir la comparación con preguntas, formatos e idiomas propios.
Capítulo 03
Ejemplo hipotético: explicar un riesgo de quiebre de stock
Supongamos un agente interno que debe responder qué productos podrían quedarse sin stock el próximo trimestre y explicar por qué. El corpus mezcla gráficos de demanda, tablas de inventario, órdenes de compra escaneadas y reportes de proveedores. En la ingestión, el parser debe conservar el vínculo entre cada celda y su encabezado, la unidad de medida, la región del gráfico y la página de origen. El índice debe guardar tanto representaciones visuales como texto estructurado, junto con versión, permisos y fecha de vigencia. Una actualización no puede borrar silenciosamente la evidencia anterior: debe producir una nueva versión auditable.
Ante una consulta, el embedding recupera un conjunto amplio: por ejemplo, reportes que mencionan el SKU, páginas con su curva de demanda y órdenes ligadas al proveedor. El reranker recibe esos candidatos, no todo el repositorio, y prioriza los que responden la relación concreta entre demanda, inventario y plazo. El agente final obtiene un paquete pequeño con fragmentos, coordenadas, score por etapa y referencias de origen. Si la respuesta omite una orden crítica, el equipo puede preguntar si la página fue parseada, si apareció en el top-k inicial y si perdió posición al reordenar. Sin esa cadena, solo verá una respuesta incorrecta y no sabrá qué componente corregir.
Capítulo 04
Siete gates antes de cambiar producción
La aceptación debe medir el recorrido completo y conservar métricas por capa. Un promedio final no basta para localizar regresiones.
Construye un conjunto de evaluación desde consultas reales autorizadas, con relevancia juzgada por personas que entienden el dominio. Incluye texto, tablas, gráficos, escaneos, varias versiones, negaciones y preguntas cuya respuesta correcta es no hay evidencia suficiente. Separa entrenamiento, ajuste y evaluación para evitar que las consultas sintéticas que ayudaron a adaptar el recuperador se conviertan también en su examen. Para cada caso conserva la página esperada, la región útil y el motivo de relevancia; así puedes medir recall del conjunto candidato, calidad del orden y fidelidad de la cita sin depender todavía del modelo generativo.
Luego ejecuta un A/B offline entre la pila vigente y la candidata con el mismo corpus congelado, la misma política de permisos y el mismo agente final. Registra p50 y p95 de latencia, uso de GPU, documentos procesados, tokens del agente y errores por tipo. Solo después ejecuta un shadow test con tráfico representativo, sin que la nueva pila responda al usuario. El rollout empieza por colecciones acotadas y puede volver a la configuración anterior sin reindexar todo. Cada gate debe tener dueño, umbral y evidencia de rollback; de lo contrario es una recomendación, no un control de publicación.
- Gate 1 — Fidelidad de parseo: tablas, gráficos, lectura, cajas y texto conservan significado y ubicación.
- Gate 2 — Cobertura candidata: la evidencia juzgada relevante aparece en el top-k antes del reranking.
- Gate 3 — Calidad de orden: el reranker sube evidencia directa sin desplazar diversidad necesaria.
- Gate 4 — Procedencia: cada afirmación puede volver a archivo, versión, página y región autorizada.
- Gate 5 — Resultado end-to-end: mejora la tarea real y sabe abstenerse cuando falta evidencia.
- Gate 6 — Presupuesto operativo: latencia, cómputo, almacenamiento y tokens caben en el SLO y el costo objetivo.
- Gate 7 — Seguridad y rollback: permisos, borrado, reindexación, observabilidad y retorno están ensayados.
Capítulo 05
Decisiones de implementación que no delegues al modelo
Define primero la unidad de evidencia. Una página completa conserva contexto visual, pero puede diluir una cláusula pequeña; un recorte mejora precisión, pero puede separar la cifra de su encabezado. Guarda ambos y enlázalos. Decide también qué documentos requieren doble o triple pasada, cuántos candidatos recupera cada clase de consulta, cuántos reordena el cross-encoder y qué diversidad mínima debe sobrevivir. Esos parámetros pertenecen a una política versionada. Si cambian sin registrar el índice, los resultados dejan de ser reproducibles y una regresión parece aleatoria.
No mezcles autorización con similitud. El filtro de permisos debe limitar el universo antes de entregar evidencia al agente y mantenerse al reordenar; un resultado relevante no adquiere acceso por obtener un score alto. Conserva además la versión original del archivo, hash, timestamp de ingestión, política aplicada y coordenadas de la región. El modelo de Embed declara que su componente textual permanece compatible con la generación anterior, lo que puede reducir el costo de una transición textual; aun así, verifica esa compatibilidad con tu serialización, dimensiones elegidas y motor vectorial antes de reutilizar un índice.
Capítulo 06
Límites, riesgos y decisión final
Los resultados publicados proceden de NVIDIA y de benchmarks concretos. ViDoRe, ParseBench, BRIGHT y BrowseComp-Plus no representan automáticamente contratos, planos, facturas o expedientes propios. Las fichas describen mezcla de datos públicos, sintéticos y etiquetados, y advierten que la integración exige pruebas específicas del caso. También existe dependencia operativa: los perfiles reportados usan GPUs NVIDIA y versiones puntuales de Transformers o vLLM; la ficha de Rerank incluso documenta rutas de serving que pueden manejar mal placeholders de imagen. Licencia, aislamiento, observabilidad, parches y capacidad de hardware forman parte de la decisión, no son trabajo posterior.
La conclusión no es que toda empresa deba adoptar esta familia. Es que la recuperación multimodal ya puede evaluarse como una cadena de contratos reemplazables. Ejecuta un piloto si hoy pierdes información en tablas o gráficos, no puedes rastrear una respuesta a la página original o gastas tokens porque el agente repite búsquedas. Mantén la pila actual si el conjunto de evaluación no muestra una mejora material o si la latencia y la operación superan el beneficio. Si necesitas diseñar el corpus, los permisos, el harness y el rollout como un sistema único, Wasyra puede ayudarte a convertir el experimento en una decisión verificable sin confundir una demo con producción.
Escrito por
Wasyra Lab
Arquitectura de sistemas IA y operaciones
Wasyra Lab publica marcos prácticos para diseñar agentes de IA, automatizaciones y flujos operativos que sí sobreviven producción.
Serie
Sistemas IA que sí llegan a producción
Una serie sobre agentes, copilots y guardrails para llevar IA al trabajo real sin romper confianza ni operación.
Posts de esta serieMás de este autor
Más de este autor
Sistemas IA
AI software factory para startups: cómo lanzar producto sin inflar equipo
Cómo usar una software factory con IA para validar, construir y operar productos SaaS con menos equipo interno y más evidencia.
ArtículoSistemas IA
Top 5 noticias de IA y desarrollo de producto que mirar ahora
Cinco movimientos recientes de OpenAI, GitHub, AWS y Anthropic que cambian cómo los equipos diseñan, construyen y operan software.
ArtículoSigue leyendo
Sigue leyendo
Sistemas IA
Datos sintéticos multilingües: seis gates
Traducir millones de documentos no crea un corpus confiable. Seis gates separan generación, aceptación, evaluación y release multilingüe.
ArtículoSistemas IA
Evaluación continua de agentes: nueve gates
Un agente puede responder rápido y estar equivocado. Nueve gates conectan evaluación offline, release, producción y aprendizaje verificable.
ArtículoSistemas IA
Modelo open-weight: cinco gates antes de alojarlo
Tener los pesos no equivale a controlar el sistema. Cinco gates para decidir si un modelo open-weight merece tu propia infraestructura.
Artículo