Datos de producción para mejorar modelos con control
AWS publicó un recorrido reproducible que captura inferencias, detecta un cambio de distribución, construye datos de entrenamiento y evalúa una nueva versión. Esta guía separa ese mecanismo de un ciclo empresarial gobernado, con minimización, consentimiento, etiquetado, holdouts y rollback.
- Publicado
- min de lectura
- 6 min de lectura
- Categoría
- Sistemas IA
En esta página
6 capítulos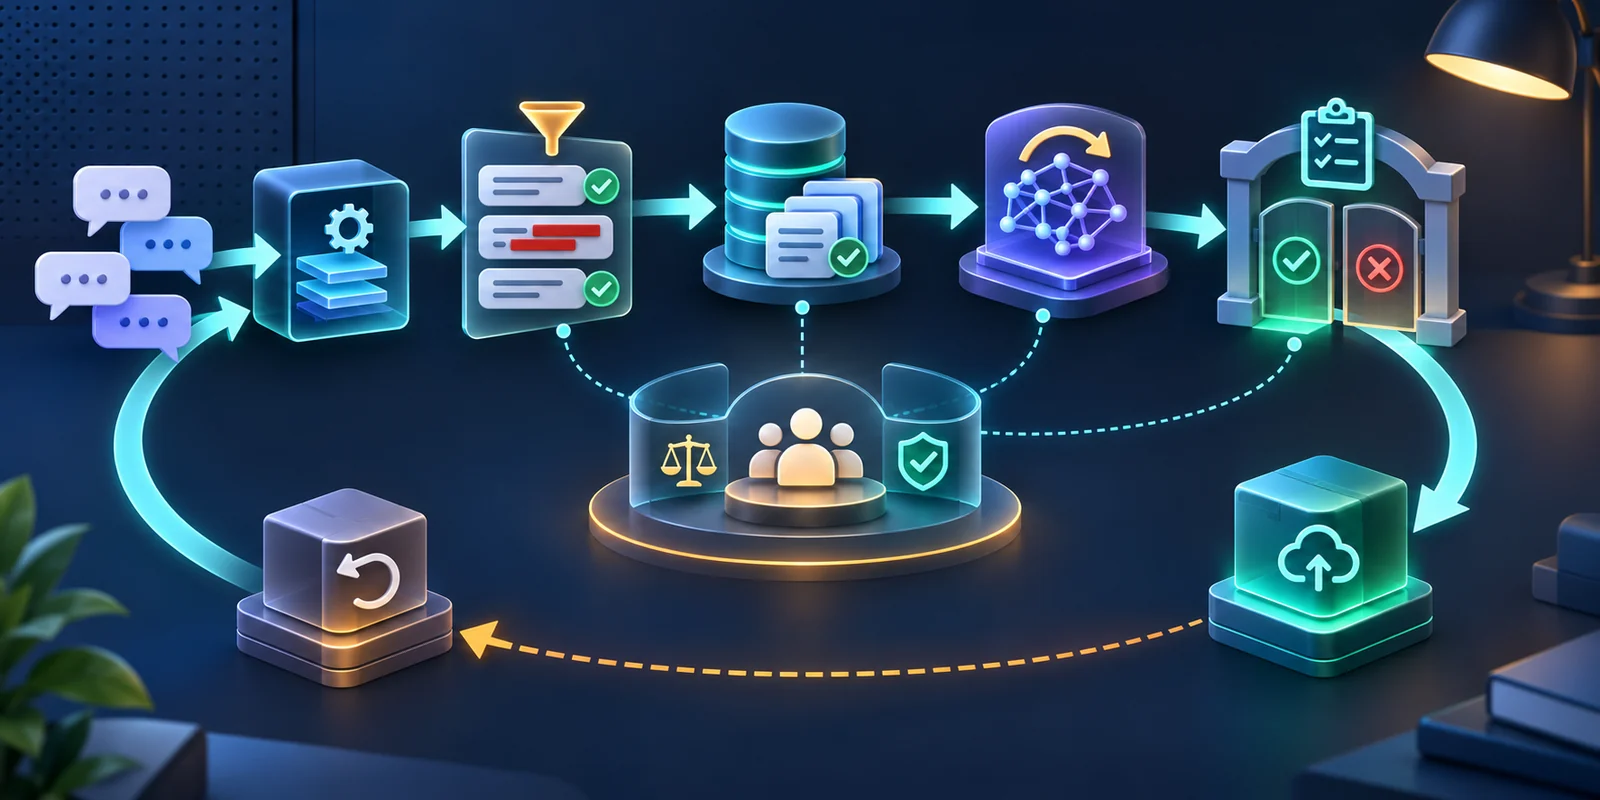
Capítulo 01
¿Cómo conviertes tráfico real en mejora de modelos?
Un ciclo útil captura solo la señal autorizada, descubre fallos repetibles, produce ejemplos revisables y despliega una versión nueva únicamente cuando supera un conjunto de evaluación independiente.
El 13 de noviembre de 2026, un día calendario antes de esta publicación en America/Lima, AWS publicó un recorrido completo de mejora con SageMaker HyperPod Data Capture. El ejemplo registra solicitudes y respuestas de un router de soporte, consulta los registros con Athena, detecta una categoría de producto nueva, aplica una política SQL de etiquetado, ajusta el modelo y compara la versión resultante contra un conjunto separado. La capacidad de captura no nació ayer: AWS la anunció el 20 de mayo. La novedad relevante de noviembre es el ejemplo reproducible, sus scripts y sus mediciones, no una función nueva ni una prueba de resultados universales.
La decisión para un CTO no es si guardar todos los prompts. Es si existe una cadena verificable desde una interacción autorizada hasta un cambio de modelo: propósito, minimización, acceso, redacción, etiqueta, procedencia, evaluación, aprobación y reversión. Si cualquiera de esos enlaces falta, el supuesto flywheel puede convertir datos personales en un dataset permanente, aprender una regla equivocada con gran confianza o mejorar un caso visible mientras degrada segmentos silenciosos. Captura es observabilidad. Entrenamiento es una intervención. Producción exige gobernar la transición entre ambos.
Capítulo 02
¿Qué capa debes capturar y para qué?
HyperPod ofrece tres puntos independientes. El endpoint de SageMaker captura payloads completos y se integra con Model Monitor; el balanceador registra metadatos de tráfico, códigos, tiempos, IP y user agent; el pod del modelo captura payloads y metadatos cerca del contenedor, con muestreo, buffering, límite de tamaño y cifrado KMS. Activar todo no equivale a observar mejor: los tiers 1 y 3 pueden duplicar el mismo contenido sensible. Elige la capa por pregunta operacional y conserva el mínimo. Disponibilidad y latencia pueden resolverse con metadatos; análisis de calidad requiere contenido, pero también controles más estrictos.
El camino técnico también crea fallos invisibles. En el ejemplo, las llamadas que evitan el proxy del pod no se capturan; una identidad de Mountpoint-S3 sin permisos puede dejar el endpoint sano mientras no llega ningún registro; y los archivos se escriben por lotes, por lo que una ausencia temporal no prueba pérdida. Instrumenta tres contadores separados: requests servidos, requests seleccionados por muestreo y registros confirmados en almacenamiento. Alerta sobre la diferencia esperada, no solo sobre HTTP 200. Versiona configuración, schema y política de retención junto al release del modelo.
| Capa | Señal útil | Riesgo principal |
|---|---|---|
| Endpoint | Payload y Model Monitor | Duplicar contenido sensible |
| Balanceador | Tráfico, errores y tiempos | No explica calidad semántica |
| Pod del modelo | Debug y dataset potencial | PII, acceso y rutas sin proxy |
Capítulo 03
Seis gates antes de entrenar con producción
Gate 1, propósito y consentimiento: define qué interacciones pueden alimentar calidad, evaluación o entrenamiento y respeta exclusiones por usuario, tenant, contrato y jurisdicción. Gate 2, minimización: captura campos necesarios, redacta secretos y datos personales antes del dataset y aplica retención corta al bruto. Gate 3, aislamiento: separa almacenamiento por ambiente y producto, cifra con claves controladas, limita lectores y registra accesos. Un bucket cifrado no resuelve una finalidad inválida ni evita que un analista exporte contenido indebido.
Gate 4, etiquetado: convierte incidentes en reglas revisables y conserva desacuerdo entre anotadores; nunca uses la propia confianza declarada por el modelo como verdad. En el ejemplo de AWS, 10 de 14 errores observados reportaban confianza de 0.9 o más, señal clara de que el número generado no estaba calibrado. Gate 5, evaluación: congela un holdout por contenido, añade regresiones de clases existentes y slices de privacidad, seguridad y formato. Gate 6, release: compara challenger y versión activa, exige aprobación para cambios materiales, despliega gradualmente y conserva artefacto, configuración y ruta de rollback.
- No promociones un registro bruto directamente a entrenamiento.
- Separa dataset de diagnóstico, dataset de entrenamiento y set de evaluación.
- Registra por ejemplo la fuente, transformación, etiqueta, revisor y versión.
- Mantén una vía de eliminación que alcance derivados y futuras reconstrucciones.
Capítulo 04
Ejemplo hipotético: un clasificador de reclamos
Imagina una aseguradora que añade una cobertura para baterías de vehículos eléctricos. Su clasificador histórico envía esos reclamos a daños eléctricos generales. El equipo captura una muestra autorizada con identificadores, pólizas, placas y texto libre redactados; una consulta detecta el nuevo patrón; especialistas definen la taxonomía y revisan casos ambiguos. La etiqueta no nace de una palabra clave como batería: combina tipo de vehículo, componente afectado y evento cubierto. Los desacuerdos quedan como ejemplos de revisión, no como respuestas forzadas.
El equipo entrena un challenger y lo evalúa sobre reclamos nuevos que nunca entraron al entrenamiento. Mide recall de la cobertura nueva, precisión por clase anterior, tasa de abstención, errores de alta severidad y estabilidad por canal e idioma. También verifica que la redacción no eliminó la señal necesaria y que ningún ejemplo contiene datos prohibidos. Solo entonces envía un porcentaje pequeño de tráfico, compara decisiones con la versión activa y mantiene revisión humana para pagos o rechazos. El modelo clasifica; el sistema transaccional conserva reglas, autorización y auditoría.
Capítulo 05
¿Cómo evalúas el flywheel y no solo el modelo?
AWS reporta en su entorno sintético que el router pasó de 235 a 280 aciertos sobre 280 tickets generados y de 16 a 20 aciertos sobre 24 probes escritos a mano. Esos resultados describen una ejecución concreta con Qwen2.5-3B-Instruct, datos sintéticos y una taxonomía limitada; no son un benchmark de HyperPod ni una promesa para tráfico empresarial. El contraste importante es que los probes manuales revelaron atajos que el set generado no veía: términos asociados al producto nuevo también aparecían en preguntas de inventario y precio. Un holdout creado por el mismo generador puede validar su propio sesgo.
Evalúa el sistema en cuatro niveles. Pipeline: cobertura de captura, retraso, duplicados, errores de decodificación y eficacia de redacción. Datos: distribución, procedencia, acuerdo, contaminación entre splits y solicitudes de borrado. Modelo: calidad por slice, calibración, abstención, seguridad y regresiones. Operación: costo por ejemplo aprobado, tiempo de revisión, latencia de inferencia, incidentes y rollback. En la prueba publicada, la diferencia de latencia entre ruta directa y proxy quedó dentro de la variación observada en ese hardware; valida de nuevo con tus payloads, concurrencia, red y sidecars.
Capítulo 06
Límites y decisión de implementación
No adoptes este patrón si no puedes establecer una base legal o contractual para reutilizar interacciones, aislar tenants, borrar derivados o financiar revisión humana. Tampoco lo uses para automatizar el aprendizaje continuo sin gate: el comportamiento de usuarios cambia en respuesta al modelo, atacantes pueden sembrar ejemplos y una mala respuesta repetida puede parecer frecuente y, por tanto, importante. Los datos de producción son sesgados por el producto, el routing, los clientes actuales y lo que el sistema ya decidió mostrar. Son evidencia operacional, no una muestra neutral del mundo.
Empieza con un ciclo de solo diagnóstico: captura limitada, redacción, consulta y un backlog de fallos sin entrenar nada. Si el equipo demuestra cobertura, trazabilidad y eliminación, añade un dataset curado y una evaluación offline. Automatiza después las transformaciones reproducibles, no la aprobación final. La oportunidad de la publicación de AWS es mostrar que las piezas técnicas ya pueden conectarse de extremo a extremo. El valor empresarial aparece cuando ese circuito conserva consentimiento, independencia de evaluación y reversibilidad. Si necesitas diseñar ese piloto sobre tus datos y restricciones, el servicio a medida de Wasyra puede convertir el flujo en arquitectura, controles y gates verificables; es distinto del producto Agents en agents.wasyra.com.
Escrito por
Wasyra Lab
Arquitectura de sistemas IA y operaciones
Wasyra Lab publica marcos prácticos para diseñar agentes de IA, automatizaciones y flujos operativos que sí sobreviven producción.
Serie
Sistemas IA que sí llegan a producción
Una serie sobre agentes, copilots y guardrails para llevar IA al trabajo real sin romper confianza ni operación.
Posts de esta serieMás de este autor
Más de este autor
Sistemas IA
Hooks para agentes: 7 pruebas antes de ejecutar herramientas
Los nuevos lifecycle hooks de AgentCore abren cuatro fronteras de control. Esta guía las convierte en siete pruebas de autorización, fallo y auditoría.
ArtículoSistemas IA
Post-training científico: 7 gates de evidencia
Nemotron for Science abre el post-training científico. Estos siete gates evitan optimizar un proxy, contaminar la prueba o desplegar falsas mejoras.
ArtículoSigue leyendo
Sigue leyendo
Sistemas IA
Hooks para agentes: 7 pruebas antes de ejecutar herramientas
Los nuevos lifecycle hooks de AgentCore abren cuatro fronteras de control. Esta guía las convierte en siete pruebas de autorización, fallo y auditoría.
ArtículoSistemas IA
Post-training científico: 7 gates de evidencia
Nemotron for Science abre el post-training científico. Estos siete gates evitan optimizar un proxy, contaminar la prueba o desplegar falsas mejoras.
ArtículoSistemas IA
Agentic RL: cómo leer MLPerf Training 6.1
MLPerf ya mide post-training de agentes. Aprende a leer tiempo hasta calidad, límites del workload y señales útiles para decidir infraestructura.
Artículo