Agentic RL: cómo leer MLPerf Training 6.1
MLPerf Training 6.1 introduce un workload de post-training con GRPO para agentes de software. Esta guía separa lo que el resultado demuestra de lo que una empresa todavía debe medir en su propio producto, datos y operación.
- Publicado
- min de lectura
- 6 min de lectura
- Categoría
- Sistemas IA
En esta página
7 capítulos- 01¿Cómo debes leer el benchmark de agentic RL de MLPerf?
- 02¿Qué mecanismo hay detrás de tiempo hasta calidad?
- 03¿Qué prueba el resultado y qué queda fuera?
- 04Ejemplo hipotético: decidir entre entrenar, alquilar o esperar
- 05Seis preguntas para una decisión de infraestructura
- 06¿Cómo evalúas sin entrenar para el marcador?
- 07La decisión: compra evidencia, no solo aceleradores
Capítulo 01
¿Cómo debes leer el benchmark de agentic RL de MLPerf?
Léelo como una prueba de sistema completo para llegar a una calidad fija, no como un ranking universal de agentes.
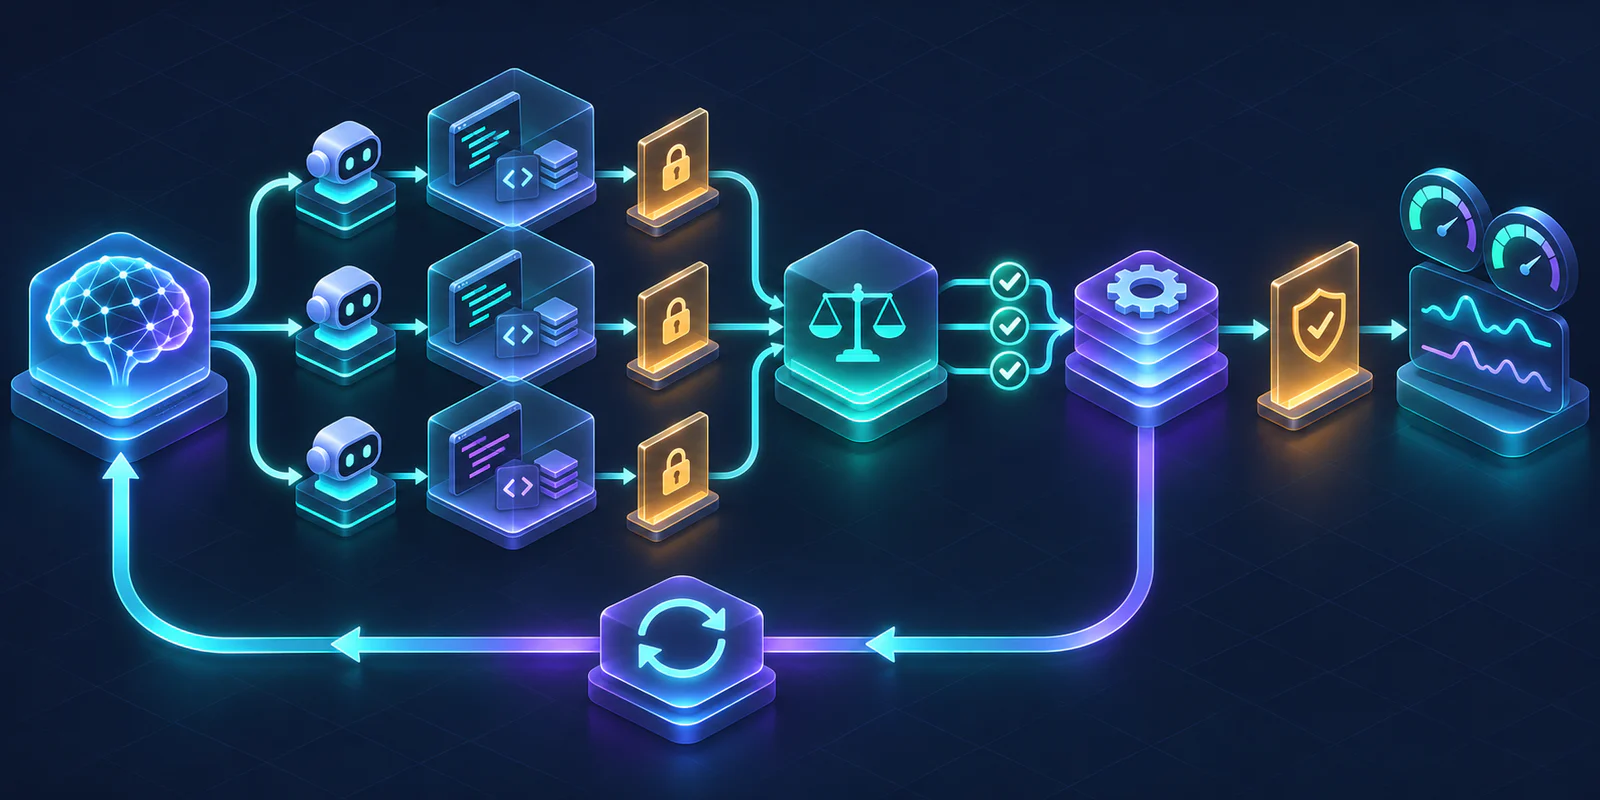
MLPerf Training 6.1 permite comparar cuánto tarda un sistema completo en llevar un modelo fijo hasta un umbral fijo mediante post-training con reinforcement learning. El workload usa Qwen3.5-397B-A17B, Group Relative Policy Optimization, tareas de reparación de software, un agente CodeAct dentro de sandbox y un objetivo de pass@4. La cifra publicada combina generación de trayectorias, ejecución de herramientas, verificación de recompensas, actualización de pesos y evaluaciones intermedias; por eso sirve para estudiar la coordinación entre aceleradores, memoria, red, almacenamiento y entornos de ejecución. No demuestra que el sistema más rápido produzca el mejor agente para tu repositorio, que tenga menor costo total, que sea seguro ni que generalice a otro dominio. Para una decisión empresarial, usa el resultado como evidencia de capacidad y eficiencia bajo un contrato reproducible; después exige una prueba propia con tus tareas, políticas, tasa de éxito, costo, fallos y restricciones operativas.
MLCommons publicó los resultados el 16 de noviembre de 2026, un día calendario antes de este artículo en America/Lima. La novedad no es solo otro modelo grande: es la incorporación de un workload estandarizado para post-training agéntico dentro de una suite revisada por pares. MLCommons reportó 153 sistemas y 250 resultados en toda la ronda; esas cifras describen participación de la suite completa, no 153 ejecuciones comparables del workload de agentic RL. Mantener esa distinción evita convertir un anuncio de cobertura en una conclusión de rendimiento.
Capítulo 02
¿Qué mecanismo hay detrás de tiempo hasta calidad?
El reloj no mide una sola multiplicación matricial. Cada prompt inicia varias trayectorias: el modelo razona, llama herramientas, modifica un repositorio aislado y recibe una recompensa cuando pruebas ocultas validan el resultado. GRPO compara las recompensas dentro del grupo, estima una ventaja relativa y actualiza la política. El ciclo repite generación y aprendizaje hasta que una evaluación offline alcanza el objetivo. En este diseño, acelerar solo el entrenamiento puede dejar ociosos los chips mientras sandboxes, compilaciones o pruebas terminan; acelerar solo la inferencia tampoco ayuda si el optimizador, los checkpoints o la red no alimentan el siguiente paso.
Las reglas fijan elementos que cambian materialmente la dificultad: hasta 30 turnos de agente, contexto máximo de 65,536 tokens, prompts de referencia, orden estable de problemas y pruebas ocultas que el agente no puede editar. También exigen divulgar el commit inmutable del harness CodeAct y sus desviaciones. Al mismo tiempo, algunos knobs siguen siendo elección del submitter, como la antigüedad máxima de una trayectoria antes de usarla en una actualización. Esa mezcla es deliberada: fija la semántica necesaria para comparar, pero deja espacio para optimizar el pipeline. Cuando leas un resultado, revisa tanto la cifra como la implementación divulgada.
Capítulo 03
¿Qué prueba el resultado y qué queda fuera?
El valor del benchmark depende de respetar su frontera de evidencia. Un resultado Closed compara sistemas bajo modelo, algoritmo, datos, contrato de agente y calidad definidos. Eso reduce variables y permite atribuir diferencias al sistema con mayor disciplina. La misma reducción impide extrapolar automáticamente a un agente comercial: tu producto puede usar otra distribución de tareas, herramientas remotas, revisiones humanas, ventanas de contexto, presupuestos o reglas de seguridad.
| Señal | Sí respalda | No respalda por sí sola |
|---|---|---|
| Tiempo hasta calidad | Velocidad del sistema completo bajo el workload fijado | Calidad superior a la meta o en tareas propias |
| Escala publicada | Capacidad de ejecutar esa configuración divulgada | Eficiencia económica en una escala menor |
| División Closed | Comparabilidad bajo restricciones comunes | Libertad para cambiar modelo, datos o objetivo |
| Pruebas ocultas | Resistencia a editar el verificador visible | Ausencia de reward hacking o fallos de seguridad |
Capítulo 04
Ejemplo hipotético: decidir entre entrenar, alquilar o esperar
Imagina una empresa B2B que quiere adaptar un agente para resolver incidencias en repositorios privados. El equipo observa un resultado MLPerf atractivo y considera reservar un clúster grande. Antes de firmar, construye un piloto con 200 incidencias históricas autorizadas, separadas por repositorio y fecha. Define éxito como parche correcto, pruebas relevantes verdes, ausencia de cambios prohibidos y aceptación por revisión humana. Mide tiempo de trayectoria, tasa de sandbox fallido, longitud de contexto, recompensas sin varianza, consumo de acelerador, costo por parche aceptado y regresiones en una suite retenida. El ejemplo es hipotético: no afirma resultados de Wasyra ni de un cliente.
Si los aceleradores esperan la mitad del tiempo por builds y pruebas, comprar más de ellos amplifica una cola externa. Si la mayoría de grupos recibe la misma recompensa, falta señal de aprendizaje y el problema puede estar en los datos o el verificador. Si la calidad sube en tareas conocidas pero cae en repositorios retenidos, el cuello no es velocidad sino generalización. El piloto convierte una tabla pública en hipótesis comprobables y revela si debes optimizar sandboxes, recompensas, muestreo, red o capacidad de entrenamiento.
Capítulo 05
Seis preguntas para una decisión de infraestructura
Primero, ¿tu workload se parece a rollouts largos con herramientas o a fine-tuning corto y offline? Segundo, ¿el objetivo es reducir tiempo calendario, costo por mejora validada o ambos? Tercero, ¿qué parte del ciclo consume tiempo: generación, sandbox, evaluación, comunicación o actualización? Cuarto, ¿puedes reproducir datos, prompts, harness y verificadores con versiones inmutables? Quinto, ¿la configuración cabe en tu capacidad normal o depende de una escala que no comprarás? Sexto, ¿qué prueba retenida y qué rollback impiden que una ganancia de recompensa degrade seguridad o utilidad?
Instrumenta cada pregunta antes de comparar proveedores. Conserva identificadores de dataset, checkpoint, política, harness y contenedor; separa tiempo de cómputo de espera; registra fallos por etapa; y calcula costo sobre ejecuciones que llegan a calidad, no sobre el precio nominal de un chip. Una corrida rápida que no converge o que necesita repetirse por un sandbox inestable no es barata. Tampoco compares resultados con distinta división, objetivo de calidad o escala como si fueran equivalentes.
- Criterio de entrada: una distribución de tareas que represente el uso real.
- Criterio de salida: calidad retenida, costo y tiempo con intervalos de variación.
- Gate de seguridad: pruebas que el agente no puede ver ni modificar.
- Gate operativo: recuperación de sandboxes, checkpoints y ejecuciones fallidas.
Capítulo 06
¿Cómo evalúas sin entrenar para el marcador?
Separa tres capas. La primera es conformidad: el pipeline reproduce el workload, llega al umbral y conserva logs auditables. La segunda es transferencia: el checkpoint mejora en repositorios y tareas retenidas que no influyeron en la recompensa. La tercera es operación: el agente respeta permisos, presupuestos, tiempos máximos y revisión humana en el producto. Una mejora en la primera capa permite comparar infraestructura; solo una mejora consistente en las tres justifica desplegar el modelo.
Los riesgos principales son reward hacking, contaminación entre train y evaluación, sobreajuste al harness, discrepancia entre pruebas y valor para la persona, y costos ocultos en entornos externos. Añade canarios negativos, mutaciones adversariales de tareas, evaluación por familia de repositorio y revisión de trayectorias fallidas. Repite corridas suficientes para observar varianza. El benchmark oficial exige al menos tres resultados para el workload de post-training y descarta extremos según sus reglas; tu piloto puede necesitar otro diseño estadístico, pero nunca debería depender de una única corrida afortunada.
Capítulo 07
La decisión: compra evidencia, no solo aceleradores
MLPerf Training 6.1 vuelve visible una realidad: entrenar agentes no es solo ejecutar backpropagation, sino coordinar rollouts, herramientas, sandboxes, verificadores y actualizaciones hasta una calidad acordada. Usa el benchmark para crear una shortlist de arquitecturas capaces, identificar patrones de pipeline y exigir divulgación técnica. No lo uses como sustituto de un caso de negocio, una prueba de generalización o un análisis de costo en tu escala.
La siguiente acción razonable es instrumentar un slice pequeño y representativo, medir sus cuellos de botella y decidir después si necesitas mejor software, más capacidad o un objetivo de entrenamiento distinto. Wasyra puede ayudarte a diseñar esa evaluación y el sistema de agentes a medida; el servicio vive separado del producto Agents y debe partir de tus datos, permisos y criterios de aceptación.
Escrito por
Wasyra Lab
Arquitectura de sistemas IA y operaciones
Wasyra Lab publica marcos prácticos para diseñar agentes de IA, automatizaciones y flujos operativos que sí sobreviven producción.
Serie
Sistemas IA que sí llegan a producción
Una serie sobre agentes, copilots y guardrails para llevar IA al trabajo real sin romper confianza ni operación.
Posts de esta serieMás de este autor
Más de este autor
Sistemas IA
Hooks para agentes: 7 pruebas antes de ejecutar herramientas
Los nuevos lifecycle hooks de AgentCore abren cuatro fronteras de control. Esta guía las convierte en siete pruebas de autorización, fallo y auditoría.
ArtículoSistemas IA
Post-training científico: 7 gates de evidencia
Nemotron for Science abre el post-training científico. Estos siete gates evitan optimizar un proxy, contaminar la prueba o desplegar falsas mejoras.
ArtículoSigue leyendo
Sigue leyendo
Sistemas IA
Hooks para agentes: 7 pruebas antes de ejecutar herramientas
Los nuevos lifecycle hooks de AgentCore abren cuatro fronteras de control. Esta guía las convierte en siete pruebas de autorización, fallo y auditoría.
ArtículoSistemas IA
Post-training científico: 7 gates de evidencia
Nemotron for Science abre el post-training científico. Estos siete gates evitan optimizar un proxy, contaminar la prueba o desplegar falsas mejoras.
ArtículoSistemas IA
Agent skills portables: contratos de producción
Una skill portable no traslada permisos ni garantías. Siete contratos separan instrucciones, herramientas, aprobación, pruebas y rollback.
Artículo