Inferencia desagregada: cuándo separar prefill y decode
AWS incorporó NVIDIA Dynamo como runtime administrado de HyperPod Inference. La decisión útil no es adoptar la novedad, sino comprobar con tráfico propio si separar el procesamiento del prompt y la generación elimina una contención real sin trasladarla a la red, al KV cache o a la operación.
- Publicado
- min de lectura
- 6 min de lectura
- Categoría
- Sistemas IA
En esta página
6 capítulos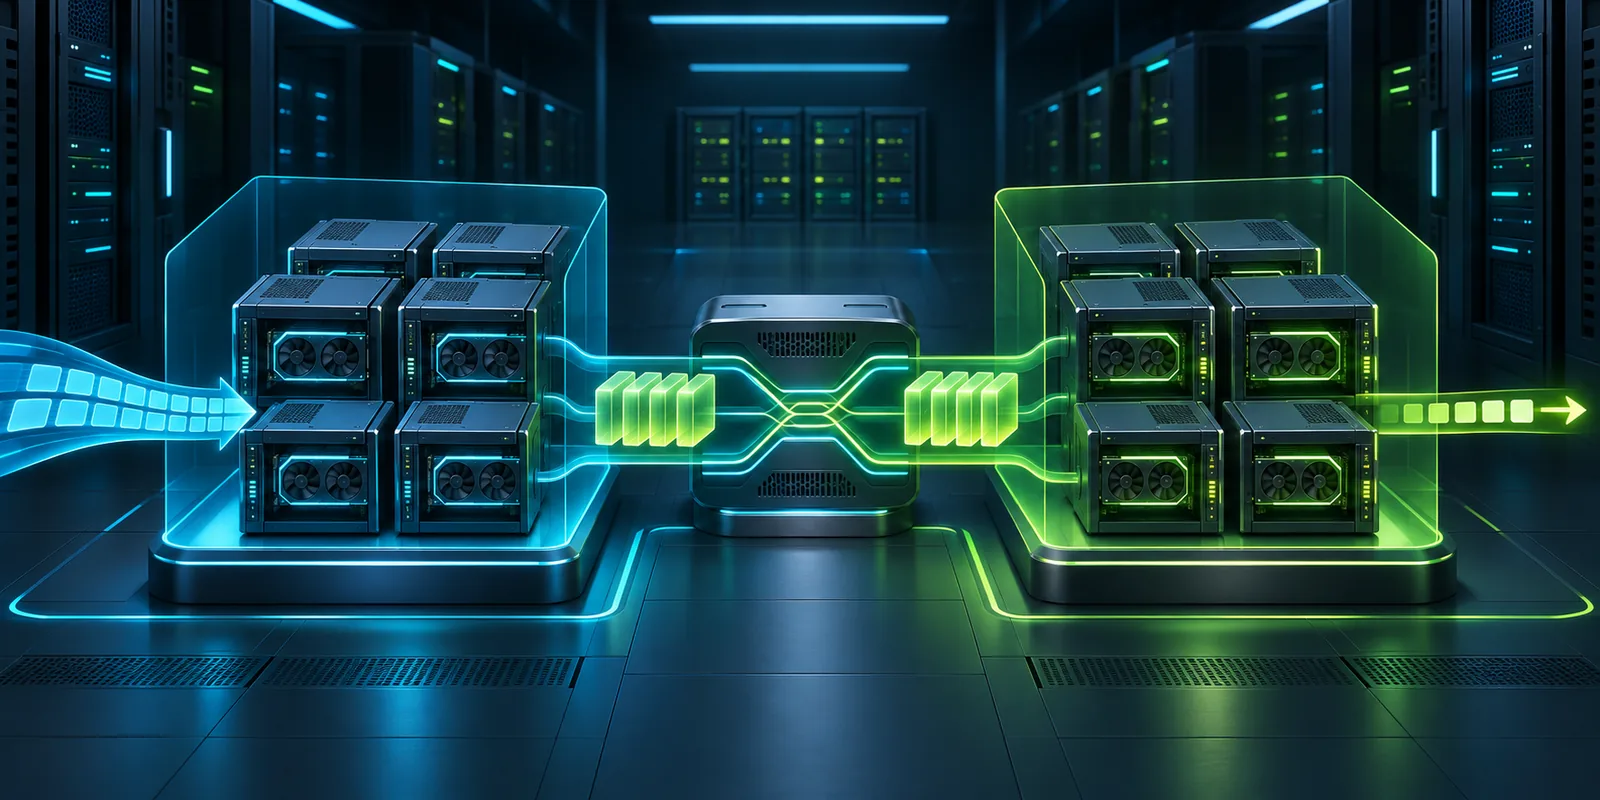
Capítulo 01
¿Cuándo compensa separar prefill y decode?
La inferencia desagregada compensa cuando el procesamiento de prompts y la generación de tokens compiten de forma sostenida, pueden dimensionarse por separado y el costo de transferir el KV cache es menor que la contención que elimina.
El 19 de noviembre de 2026, tres días calendario antes de este artículo en America/Lima, AWS publicó su revisión técnica de inferencia y destacó NVIDIA Dynamo administrado en SageMaker HyperPod Inference. La release v3.8 que habilita el runtime está fechada el 18 de noviembre. El mecanismo separa prefill, la fase que procesa el prompt y construye el KV cache, de decode, la fase que genera tokens de manera autoregresiva. Cada pool puede usar una cantidad, paralelismo y perfil de GPU diferentes; un router coordina la solicitud y el cache se transfiere al worker que continuará la generación. Separar compensa cuando prompts largos bloquean tokens activos, ambas fases exigen capacidades distintas y una prueba representativa demuestra que el handoff cuesta menos que la contención eliminada. Si esas tres condiciones no aparecen juntas, serving agregado conserva una ruta más simple y eficiente.
Esa separación no es una mejora universal. A baja concurrencia, un worker agregado evita transferencia, coordinación y fragmentación de capacidad. La desagregación gana valor cuando prompts largos o irregulares bloquean generación, cuando prefill y decode exigen recursos distintos o cuando un modelo necesita varias máquinas. La decisión correcta parte de una cola y un objetivo de servicio observables: tiempo al primer token, latencia entre tokens, throughput aceptado, errores y costo por solicitud terminada. Si el equipo no puede atribuir el cuello de botella a una fase, todavía no tiene evidencia para añadir otra topología.
Capítulo 02
Qué cambia realmente en la ruta de una solicitud
En una topología agregada, el mismo worker recibe tokens de entrada, ejecuta prefill, conserva el KV cache y realiza decode. Es simple, mantiene el cache local y suele ser eficiente mientras ambas fases caben en un perfil operativo estable. En una topología desagregada, el frontend selecciona un worker de prefill, este produce el cache y entrega metadatos de handoff; después el router elige un worker de decode, mueve o referencia los bloques necesarios y transmite la respuesta. La independencia permite escalar cada pool por su propia presión, pero introduce una frontera distribuida en cada solicitud.
Dynamo también hace routing consciente de KV cache. En vez de balancear solo por cantidad de solicitudes, puede considerar superposición de prefijos y carga para evitar recomputar contexto. Sin embargo, la documentación advierte que decode no debe perseguir reutilización de prefijo después de un prefill remoto como si esos bloques se deduplicaran mágicamente. La topología y el motor deben compartir una verdad sobre dónde vive el cache, cómo se transfiere y cuándo queda inválido. Una métrica de hit rate aislada no prueba beneficio si la transferencia aumenta la cola o reduce memoria disponible para secuencias activas.
| Decisión | Agregada | Desagregada |
|---|---|---|
| Ruta | Un worker hace ambas fases | Pools separados con handoff |
| Escalado | Una capacidad conjunta | Prefill y decode independientes |
| KV cache | Local al worker | Debe transferirse o compartirse |
| Riesgo principal | Contención entre fases | Red, routing y capacidad fragmentada |
Capítulo 03
Seis señales antes de cambiar la topología
Primera, distribución de entrada: mide longitud de prompt, reutilización de prefijos y ráfagas, no solo el promedio. Segunda, distribución de salida: decode escala con concurrencia, tokens generados y memoria activa. Tercera, contención: demuestra que un prefill largo eleva latencia entre tokens o bloquea generación para otras solicitudes. Cuarta, localidad de cache: registra hits útiles, evicciones y bytes transferidos por solicitud. Quinta, red y colocación: verifica que el transporte esperado funciona entre nodos y que la afinidad no convierte un fallo de rack o zona en una cascada. Sexta, economía aceptada: calcula costo por solicitud que cumple todos los SLO, no tokens teóricos por GPU.
El benchmark publicado por AWS ilustra por qué la forma de la carga importa. Para Qwen3-235B-A22B-FP8, con TensorRT-LLM sobre dos instancias p5en.48xlarge, entradas de 4,000 tokens y salidas de 200, AWS retuvo puntos que cumplían P90 de tiempo al primer token menor a un segundo y al menos 50 tokens por segundo por usuario. En ese experimento, la mejor configuración desagregada alcanzó 207 tokens de salida por segundo por GPU frente a 101 en la agregada. Es un resultado de esa combinación, no un multiplicador transferible a otro modelo, red, motor o distribución de tráfico.
Capítulo 04
¿Cómo diseñar una prueba que sí decida?
Empieza con replay de tráfico representativo y anonimizado o con una distribución sintética documentada. El ejemplo es hipotético: un asistente técnico recibe prompts base de 6,000 tokens, recupera entre 0 y 20,000 tokens y genera respuestas de 100 a 1,200 tokens. Construye una matriz por longitud de entrada, salida, concurrencia y reutilización de prefijo. Para cada celda compara la configuración agregada vigente contra varios ratios de prefill y decode, manteniendo modelo, precisión, motor, límites de batching y criterios de aceptación. Calienta cache de forma explícita y separa resultados cold, warm y después de evicciones.
Promueve solo puntos que cumplen simultáneamente P50/P95/P99 de TTFT, latencia entre tokens, throughput, error rate y memoria de seguridad. Después añade costo: GPU-segundos, red, almacenamiento de cache y capacidad ociosa. Finalmente prueba degradación: pérdida de un worker de prefill, un decode saturado, cache miss masivo, handoff lento, rollout parcial y reinicio del router. La documentación de Dynamo señala que durante la activación de rutas desagregadas puede devolver HTTP 503 en vez de enviar una solicitud a un decode incompatible; el cliente debe reintentar con presupuesto y jitter, no duplicar trabajo sin límite.
Capítulo 05
Los riesgos que un benchmark feliz no muestra
La desagregación reserva GPUs para pools con perfiles diferentes. Si decode está limitado por capacidad de KV cache, mover GPUs hacia prefill puede reducir concurrencia total aunque mejore TTFT. Si el tráfico cae, dos pools pequeños pueden quedar menos ocupados que uno compartido. Si la red no entrega el ancho de banda y latencia previstos, el handoff reemplaza contención de cómputo por espera distribuida. Y si routing, autoscaling y métricas no comparten etiquetas de modelo, versión y tenant, una mejora agregada puede esconder regresiones en la cola que paga el negocio.
Managed no significa sin responsabilidad. HyperPod instala y actualiza componentes, administra capacidad y recupera nodos, mientras Dynamo decide sharding, separación de fases y routing. El equipo aún debe elegir recetas, límites, ratios, políticas de rollout y señales de rollback. Mantén una ruta agregada validada para cargas que no se benefician, define compatibilidad por versión y no cambies topología y motor al mismo tiempo. La frontera de rollback debe incluir configuración, cache, router y cliente; volver solo el modelo puede dejar solicitudes en una ruta incoherente.
Capítulo 06
La decisión: elimina una contención, no compres una topología
Mantén serving agregado cuando la carga es pequeña o estable, el cache local funciona, no hay interferencia medible entre fases y el margen operativo vale más que una optimización teórica. Prueba desagregación cuando prompts largos bloquean decode, los perfiles de entrada y salida divergen, necesitas escalar pools de forma independiente o el modelo debe abarcar nodos. Adopta solo si la ganancia permanece en varios periodos, sobrevive fallos y reduce costo por solicitud aceptada después de contar red y capacidad ociosa.
El avance de AWS reduce trabajo de plataforma, pero no sustituye el experimento. Convierte las seis señales en un contrato de promoción: distribución de entrada, distribución de salida, contención, localidad de cache, transporte y economía aceptada. Si cada una tiene una métrica, un umbral y un dueño, la topología puede evolucionar sin convertir producción en laboratorio. Si estás diseñando una ruta de inferencia para un producto real, Wasyra puede ayudarte a construir el benchmark representativo, la observabilidad y el rollout acotado antes de comprometer arquitectura y gasto.
Escrito por
Wasyra Lab
Arquitectura de sistemas IA y operaciones
Wasyra Lab publica marcos prácticos para diseñar agentes de IA, automatizaciones y flujos operativos que sí sobreviven producción.
Serie
Sistemas IA que sí llegan a producción
Una serie sobre agentes, copilots y guardrails para llevar IA al trabajo real sin romper confianza ni operación.
Posts de esta serieMás de este autor
Más de este autor
Sistemas IA
Hooks para agentes: 7 pruebas antes de ejecutar herramientas
Los nuevos lifecycle hooks de AgentCore abren cuatro fronteras de control. Esta guía las convierte en siete pruebas de autorización, fallo y auditoría.
ArtículoSistemas IA
Post-training científico: 7 gates de evidencia
Nemotron for Science abre el post-training científico. Estos siete gates evitan optimizar un proxy, contaminar la prueba o desplegar falsas mejoras.
ArtículoSigue leyendo
Sigue leyendo
Sistemas IA
Hooks para agentes: 7 pruebas antes de ejecutar herramientas
Los nuevos lifecycle hooks de AgentCore abren cuatro fronteras de control. Esta guía las convierte en siete pruebas de autorización, fallo y auditoría.
ArtículoSistemas IA
Post-training científico: 7 gates de evidencia
Nemotron for Science abre el post-training científico. Estos siete gates evitan optimizar un proxy, contaminar la prueba o desplegar falsas mejoras.
ArtículoSistemas IA
Agentic RL: cómo leer MLPerf Training 6.1
MLPerf ya mide post-training de agentes. Aprende a leer tiempo hasta calidad, límites del workload y señales útiles para decidir infraestructura.
Artículo