RAG agéntico: elige el esfuerzo de recuperación
Amazon Bedrock Managed Knowledge Base ahora permite usar la misma API para devolver solo pasajes, responder tras una búsqueda o planificar búsquedas iterativas. Esta guía convierte ese control en una política medible de routing, evidencia y evaluación para equipos que operan RAG empresarial.
- Publicado
- min de lectura
- 7 min de lectura
- Categoría
- Sistemas IA
En esta página
7 capítulos- 01¿Cuándo necesita una pregunta RAG agéntico?
- 02El mecanismo: tres salidas, no tres productos
- 03¿Cómo enrutas una consulta sin pedirle al modelo que se juzgue?
- 04Ejemplo hipotético: políticas de compras con tres rutas
- 05¿Cómo evalúas calidad, latencia y costo juntos?
- 06Los límites: más búsquedas no reparan un corpus roto
- 07La decisión: compra evidencia, no iteraciones
Capítulo 01
¿Cuándo necesita una pregunta RAG agéntico?
Una pregunta necesita recuperación agéntica cuando su respuesta depende de reunir y comprobar evidencia distribuida, no solo de encontrar un pasaje parecido.
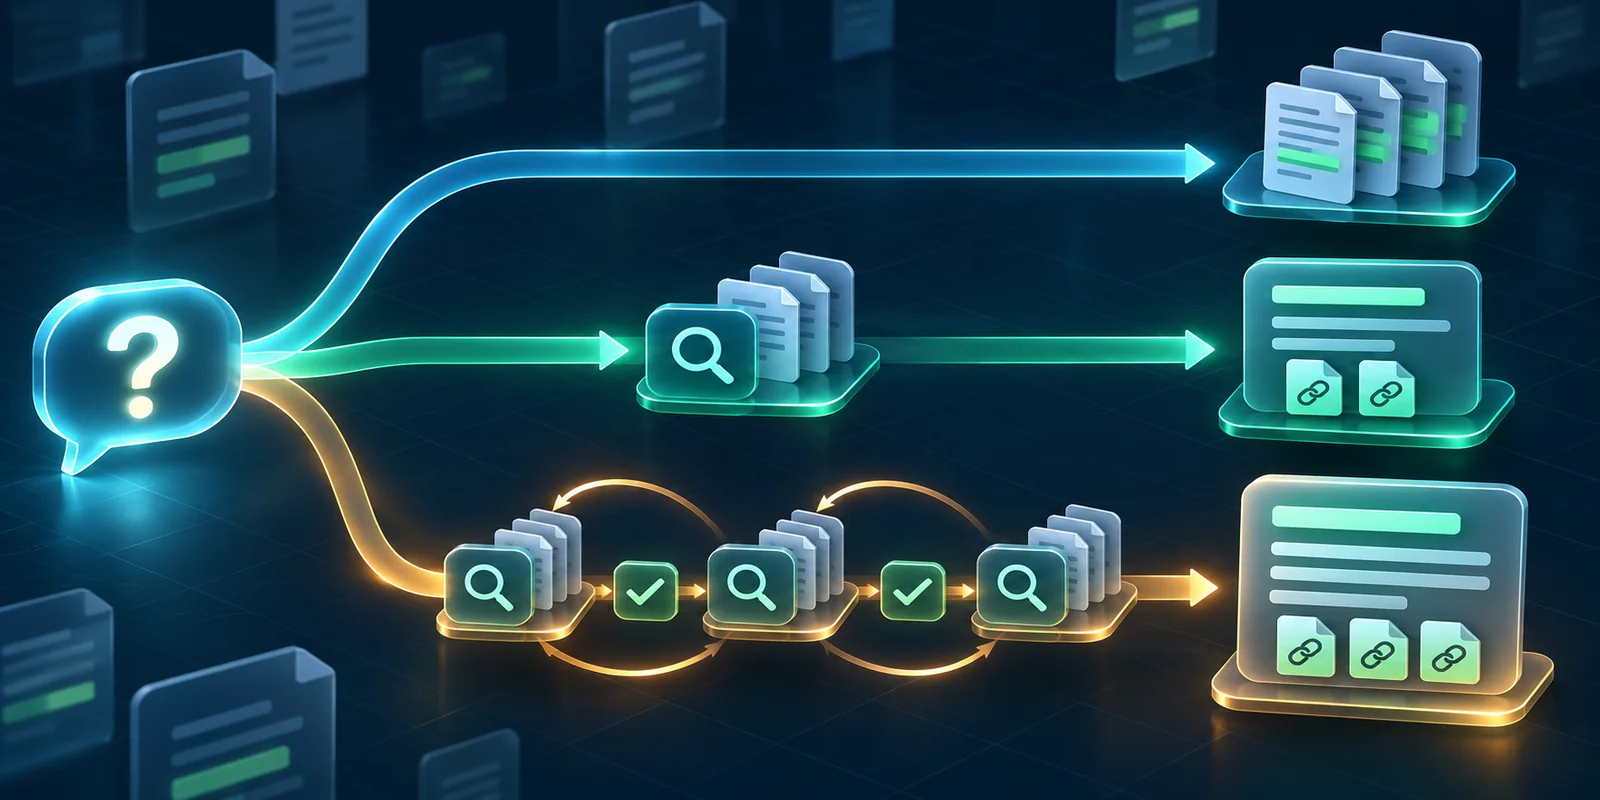
El 9 de noviembre de 2026, un día calendario antes de esta publicación en America/Lima, AWS anunció que AgenticRetrieveStream admite tres comportamientos en Amazon Bedrock Managed Knowledge Base. Con maxAgentIteration igual a 0 devuelve pasajes sin generar una respuesta; con 1 hace una recuperación y luego responde; con valores de 2 a 5 conserva el flujo agéntico que planifica y refina búsquedas. La decisión correcta no es activar siempre el modo más profundo. Usa solo pasajes cuando una persona o una aplicación necesita inspeccionar la fuente; una búsqueda para consultas directas cuya evidencia vive en un bloque bien definido; e iteraciones cuando hay que comparar entidades, reconciliar documentos o cubrir varias partes de una pregunta. Elige el menor modo que supera un umbral propio de respuesta correcta y evidencia suficiente. Así, latencia y uso de modelo se vuelven consecuencias medibles de la dificultad documental, no un impuesto fijo para todo el tráfico.
AWS explica que una iteración equivale a una llamada al modelo y que la última queda reservada para generar la respuesta. Por eso un límite n permite como máximo n menos 1 rondas de planificación. La recuperación especulativa inicial no consume ese conteo. Es un contrato operativo útil porque convierte una noción vaga de profundidad en un presupuesto observable, pero no clasifica preguntas por ti ni garantiza que más rondas encuentren mejores fuentes. La aplicación sigue siendo responsable de elegir el modo, controlar qué corpus puede consultar cada identidad y decidir cuándo una respuesta carece de soporte suficiente.
Capítulo 02
El mecanismo: tres salidas, no tres productos
La ventaja arquitectónica es conservar un solo contrato de entrada y variar la cantidad de trabajo. El modo 0 ejecuta recuperación garantizada y entrega los pasajes deduplicados; no invoca un modelo generativo y generateResponse debe ser false. El modo 1 recupera una vez y usa una llamada de modelo para redactar una respuesta fundamentada. Los modos 2 a 5 permiten que un planificador descomponga la pregunta, reformule búsquedas, evalúe huecos y finalmente sintetice. Todos pueden consultar varias bases: single-shot describe la ausencia de planificación iterativa, no una restricción a una sola fuente.
Trata el valor como un máximo, no como una promesa de calidad. Una pregunta compleja puede detenerse con evidencia incompleta; una directa puede recibir demasiados pasajes irrelevantes si el índice o los metadatos son deficientes. El control de esfuerzo solo actúa después de la ingestión, partición, embeddings, filtros y permisos. Si esas capas fallan, agregar planificación puede producir una explicación más convincente del corpus equivocado. El routing debe guardar consulta, modo elegido, versión del corpus, filtros, iteraciones reales, fuentes recuperadas y resultado del evaluador.
| Modo | Trabajo del sistema | Uso apropiado | Riesgo principal |
|---|---|---|---|
| 0 · Pasajes | Una recuperación, sin respuesta generada | Revisión humana o composición externa | Fuente relevante pero insuficiente |
| 1 · Single-shot | Una recuperación y una respuesta | Lookup directo y bien acotado | Una búsqueda omite otra evidencia |
| 2–5 · Agéntico | Planificación, búsquedas y síntesis | Comparación y preguntas multipartes | Más trabajo sin mejor soporte |
Capítulo 03
¿Cómo enrutas una consulta sin pedirle al modelo que se juzgue?
Empieza por reglas observables. Una solicitud explícita de ver el texto original va al modo 0. Un identificador exacto, una política concreta y una respuesta localizada en un documento vigente pueden empezar en 1. Comparaciones entre entidades, preguntas con varias condiciones, resúmenes completos y consultas que requieren reconciliar fechas empiezan en un modo agéntico acotado. No confíes solo en un clasificador semántico: combina tipo de workflow, estructura esperada de evidencia, número de entidades, amplitud temporal y necesidad de cobertura. La clasificación puede proponer; una política versionada decide.
Define después el escalamiento. Si single-shot no recupera una fuente con autoridad suficiente, no alcanza cobertura de los subtemas esperados o detecta versiones en conflicto, puede reemitirse una vez con mayor esfuerzo. El escalamiento debe conservar un ID de solicitud y registrar por qué ocurrió. Evita el bucle automático donde la respuesta se califica a sí misma y compra más búsquedas hasta parecer segura. Usa señales externas: metadatos de vigencia, cobertura de campos obligatorios, presencia de citas, un verificador de entailment o revisión humana para dominios de alto impacto.
Capítulo 04
Ejemplo hipotético: políticas de compras con tres rutas
Imagina un asistente interno hipotético para compras. La pregunta “muéstrame el texto vigente sobre anticipos” solicita evidencia primaria y usa modo 0; la interfaz presenta pasaje, documento, versión y fecha, sin redactar una regla nueva. “¿Qué aprobación necesita un anticipo menor a S/ 5,000?” puede usar modo 1 si importe, moneda y autoridad aparecen juntos en una política vigente. Antes de mostrar la respuesta, la aplicación verifica que la cita contiene el umbral y el rol aprobador, y que el filtro de país coincide con la identidad del usuario.
“Compara los controles para anticipos de contratistas en Perú y Colombia, incluye excepciones y señala conflictos entre la política global y los anexos locales” necesita descomposición. El modo agéntico busca por país, control y excepción; conserva las fuentes separadas y sintetiza solo después. Si falta el anexo colombiano o dos versiones tienen la misma vigencia, el resultado correcto es incompleto o requiere revisión, no una comparación fluida. Ninguna ruta autoriza un pago: recuperar política y ejecutar una transacción son permisos distintos. El asistente puede informar requisitos; el sistema transaccional mantiene aprobación, segregación de funciones e idempotencia.
Capítulo 05
¿Cómo evalúas calidad, latencia y costo juntos?
Construye un set estratificado con consultas directas, multipartes, ambiguas, fuera del corpus y adversariales. Para cada una guarda la clase esperada, las fuentes autorizadas, los hechos obligatorios y una respuesta aceptable o un estado de abstención. Ejecuta los mismos casos en 0, 1 y al menos un límite agéntico, manteniendo corpus, filtros y modelo constantes. Evalúa recuperación antes de generación: cobertura de fuentes, precisión de pasajes, versión correcta y ausencia de documentos prohibidos. Después mide soporte de cada afirmación, completitud, contradicciones y calidad de abstención.
Registra tiempo hasta primer evento, latencia total, llamadas de modelo, iteraciones reales, tokens, búsquedas, documentos expandidos y minutos de revisión humana. Calcula costo por respuesta aceptada, no por request: incluye escalaciones, reintentos y correcciones. La comparación debe producir fronteras de decisión, por ejemplo que una clase directa use 1 mientras cumpla soporte y p95, y que una clase comparativa use 3 porque 2 pierde una fuente obligatoria. No publiques esos números como universales; dependen del corpus, la región, el modelo, los filtros y el patrón de preguntas.
Capítulo 06
Los límites: más búsquedas no reparan un corpus roto
El anuncio de AWS no presenta un benchmark que demuestre una mejora universal ni cuantifica ahorro de costo o latencia. Su asistente bancario es ilustrativo. Tampoco probamos el servicio en esta publicación. La ventaja documentada es control explícito sobre el trabajo, no precisión garantizada. Si faltan documentos, el chunking separa condiciones de excepciones, los metadatos de vigencia están mal o el usuario puede recuperar una colección indebida, ninguna cantidad de planificación corrige la base. La primera investigación de un fallo debe distinguir ingestión, retrieval, reranking, planificación, generación y rendering de citas.
Hay además límites del contrato. El modo 0 entrega pasajes en un formato de stream que no incluye necesariamente los mismos campos que Retrieve; generateResponse true con cero iteraciones produce un error 4xx. La documentación de observabilidad expone invocaciones, errores, throttles y TotalIterationCount, pero esa métrica no demuestra corrección. Conserva trazas de aplicación que enlacen cada respuesta con fuentes y política de routing, elimina contenido sensible de logs y prueba que un cambio de configuración no amplíe fuentes o permisos. Un dashboard verde puede mostrar disponibilidad mientras el sistema cita la política equivocada.
Capítulo 07
La decisión: compra evidencia, no iteraciones
Adopta el control de esfuerzo cuando puedas nombrar clases de preguntas, definir evidencia suficiente y observar el costo completo de cada ruta. Empieza por un default conservador: modo 1 para lookups bien acotados, 0 para revisión de fuentes y un límite agéntico solo para clases que demuestren mejor cobertura. Añade una salida explícita de no encontrado y un escalamiento único basado en señales externas. Revisa la política al cambiar corpus, embeddings, reranker, modelo o instrucciones, porque cada modificación puede mover la frontera entre búsqueda directa e iterativa.
La novedad útil no es llamar agéntico a todo el RAG, sino poder pagar profundidad cuando la estructura de la pregunta la exige y omitirla cuando no aporta evidencia. Un piloto serio deja una matriz reproducible de consultas, modos, fuentes, aceptación, latencia y costo. Si necesitas convertir documentos y permisos reales en ese piloto, el servicio a medida de Wasyra puede diseñar la arquitectura, el set de evaluación y los gates de despliegue. Es un servicio de implementación distinto del producto Agents alojado en agents.wasyra.com.
Escrito por
Wasyra Lab
Arquitectura de sistemas IA y operaciones
Wasyra Lab publica marcos prácticos para diseñar agentes de IA, automatizaciones y flujos operativos que sí sobreviven producción.
Serie
Sistemas IA que sí llegan a producción
Una serie sobre agentes, copilots y guardrails para llevar IA al trabajo real sin romper confianza ni operación.
Posts de esta serieMás de este autor
Más de este autor
Sistemas IA
Hooks para agentes: 7 pruebas antes de ejecutar herramientas
Los nuevos lifecycle hooks de AgentCore abren cuatro fronteras de control. Esta guía las convierte en siete pruebas de autorización, fallo y auditoría.
ArtículoSistemas IA
Post-training científico: 7 gates de evidencia
Nemotron for Science abre el post-training científico. Estos siete gates evitan optimizar un proxy, contaminar la prueba o desplegar falsas mejoras.
ArtículoSigue leyendo
Sigue leyendo
Sistemas IA
Hooks para agentes: 7 pruebas antes de ejecutar herramientas
Los nuevos lifecycle hooks de AgentCore abren cuatro fronteras de control. Esta guía las convierte en siete pruebas de autorización, fallo y auditoría.
ArtículoSistemas IA
Post-training científico: 7 gates de evidencia
Nemotron for Science abre el post-training científico. Estos siete gates evitan optimizar un proxy, contaminar la prueba o desplegar falsas mejoras.
ArtículoSistemas IA
Agentic RL: cómo leer MLPerf Training 6.1
MLPerf ya mide post-training de agentes. Aprende a leer tiempo hasta calidad, límites del workload y señales útiles para decidir infraestructura.
Artículo