Centros de datos IA: diseña demanda flexible
El programa Grid Protectors de OpenAI vuelve concreta una decisión de infraestructura: qué cómputo puede reducirse durante estrés de red, bajo qué contrato y con qué evidencia de recuperación.
- Publicado
- min de lectura
- 7 min de lectura
- Categoría
- Ingeniería
En esta página
7 capítulos- 01¿Qué cambia al tratar el cómputo IA como demanda flexible?
- 02¿Cómo funciona la demanda flexible sin degradar el producto?
- 03Ejemplo hipotético: reducir 30 MW sin perder control
- 04Seis gates antes de comprometer capacidad flexible
- 05¿Cómo se evalúa la flexibilidad antes de una emergencia?
- 06Límites y riesgos que el contrato no elimina
- 07La decisión: compra capacidad como un sistema operable
Capítulo 01
¿Qué cambia al tratar el cómputo IA como demanda flexible?
La capacidad deja de ser solo una reserva de GPUs y pasa a ser un servicio con límites de reducción, tiempos de respuesta, recuperación y responsabilidad económica.
El 2 de noviembre de 2026, un día calendario antes de esta publicación en America/Lima, OpenAI anunció Grid Protectors, un programa para que futuros campus de cómputo reduzcan consumo cuando la red eléctrica esté bajo presión. El piloto descrito para Effingham County parte de un contrato ya aprobado con Georgia Power: el proyecto contempla 3.200 MW de nueva demanda y hasta 1.000 MW de respuesta flexible. La decisión útil para un CTO no es asumir que toda carga IA puede apagarse. Es convertir cada servicio, entrenamiento y trabajo batch en una clase operativa con potencia reducible, aviso requerido, duración tolerable, estado persistido y objetivo de recuperación. Después hay que reflejar esas clases en el contrato eléctrico, el scheduler y los SLO del producto. Sin esa cadena, una promesa comercial de flexibilidad puede desplazar el riesgo hacia usuarios, modelos, datos o la propia red.
El anuncio describe una intención nacional y un caso inicial, no una prueba de que cualquier campus pueda entregar la misma flexibilidad. OpenAI dice que los acuerdos cambiarán según la ubicación y que todavía publicará compromisos adicionales. También afirma que la flexibilidad no sustituye nueva generación ni transmisión. Ese límite importa: reducir demanda durante un pico puede evitar parte de la capacidad marginal, pero no crea energía, no resuelve por sí solo una interconexión y no elimina el costo fijo de líneas, subestaciones o respaldo. El criterio de aceptación debe separar la capacidad contratada, la reducción realmente disponible y el desempeño observado durante un evento.
Capítulo 02
¿Cómo funciona la demanda flexible sin degradar el producto?
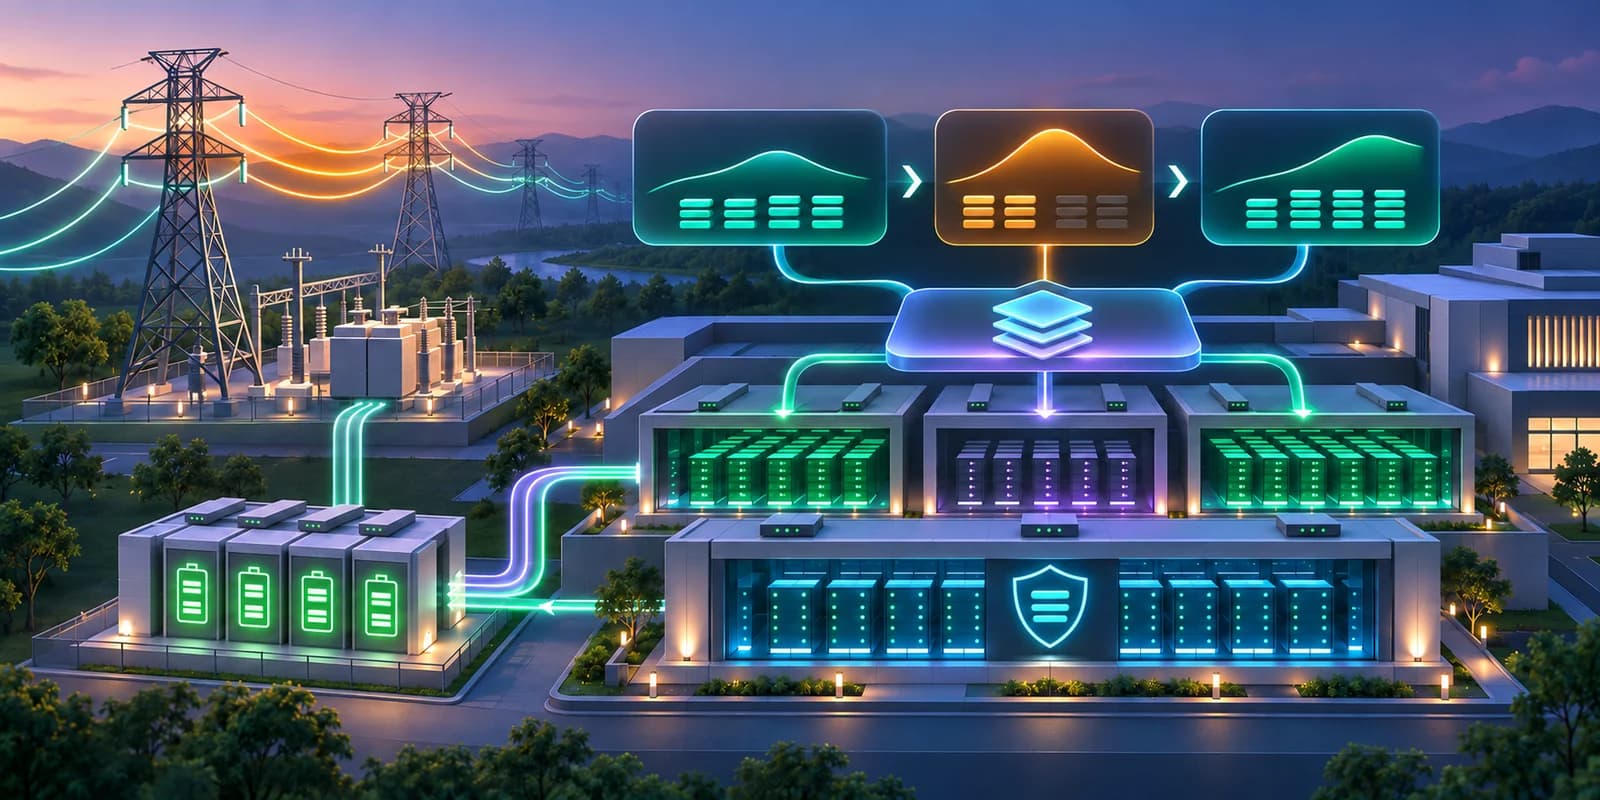
Un evento de respuesta a la demanda empieza fuera del cluster: la utility o el operador solicita una reducción con un objetivo, una hora de inicio y una duración. El campus traduce ese pedido a un presupuesto de potencia y el control plane decide qué cargas pausar, desplazar, limitar o alimentar temporalmente con almacenamiento. El orden correcto no se deduce de la utilización de GPU. Debe venir de una política que proteja inferencia crítica, comunicaciones, almacenamiento y funciones de seguridad; aproveche checkpointing para entrenamiento; drene trabajos batch; y limite nuevas admisiones antes de matar procesos con estado no persistido.
La batería ayuda a suavizar rampas o cubrir la transición, pero no debe contarse dos veces como energía para continuidad y como capacidad comprometida con la red. Del mismo modo, la generación local puede aportar potencia si permisos, combustible, emisiones, sincronización y seguridad lo permiten; el anuncio solo la presenta como una opción dependiente del sitio. El contrato técnico necesita una jerarquía explícita: primero reducir trabajo diferible, después usar almacenamiento dentro de su reserva, y conservar suficiente margen para recuperación y contingencias. El producto debe conocer el modo degradado antes del primer evento real.
| Campo | Contrato | Evidencia técnica |
|---|---|---|
| Potencia reducible | MW comprometidos por ventana | Inventario de cargas y medición en el punto acordado |
| Aviso | Tiempo entre orden e inicio | Latencia extremo a extremo del control plane |
| Rampa | Velocidad máxima de reducción | Curva de potencia sin oscilaciones inseguras |
| Duración | Minutos u horas sostenibles | Backlog, autonomía y estado de checkpoints |
| Recuperación | Reglas al liberar la reducción | Arranque escalonado y SLO de retorno |
| Responsabilidad | Costos, garantías e incumplimiento | Medición reconciliada y registro del evento |
Capítulo 03
Ejemplo hipotético: reducir 30 MW sin perder control
Imagina, de forma hipotética, un campus con inferencia interactiva, fine-tuning nocturno y generación batch. La utility emite una orden para reducir 30 MW durante 90 minutos con quince minutos de aviso. El policy engine congela nuevas admisiones batch, solicita checkpoints a los entrenamientos elegibles y baja límites de concurrencia en endpoints no críticos. La batería cubre la rampa mientras los jobs confirman estado durable. Los endpoints prioritarios conservan capacidad y publican un presupuesto de latencia más conservador. Si los checkpoints no terminan a tiempo, ese bloque no cuenta como reducción disponible y otra clase preaprobada ocupa su lugar.
La parte difícil llega al final. Reiniciar todo al mismo tiempo crea un segundo pico, presiona almacenamiento y red, recompone cachés y puede elevar errores justo cuando el evento termina. El recovery controller libera capacidad por etapas según temperatura, potencia, cola y salud del servicio. El backlog batch se procesa con un límite para no desplazar inferencia. El incidente solo se cierra cuando la medición eléctrica concilia la reducción solicitada, el runtime confirma qué jobs cambiaron de estado y los SLO de producto vuelven a su banda. El ejemplo no es un benchmark ni describe el campus de OpenAI; muestra el tipo de máquina de estados que un compromiso serio necesita.
Capítulo 04
Seis gates antes de comprometer capacidad flexible
Primero, clasifica cargas por impacto y dependencia, no por equipo propietario. Segundo, demuestra que el estado se conserva: checkpoint, idempotencia, reintento y consistencia deben probarse con interrupciones reales. Tercero, mide potencia en el límite contractual y enlázala con decisiones del scheduler mediante un ID de evento común. Cuarto, prueba la rampa de bajada y la de recuperación; ambas pueden perturbar la red y el servicio. Quinto, verifica el modo degradado con usuarios sintéticos y SLO separados. Sexto, reconcilia costos, capacidad prometida, reducción entregada y excepciones en un recibo que puedan revisar ingeniería, finanzas y operaciones.
Cada gate necesita una condición de rechazo. Un inventario sin owner no entra al pool flexible. Un entrenamiento sin checkpoint probado se considera firme. Una batería sin estado de carga confiable no respalda el compromiso. Una señal de utility sin autenticación, expiración y protección contra replay no puede gobernar el cluster. Una reducción que cumple MW pero rompe el SLO crítico es un fallo conjunto, no un éxito energético. Y un evento sin medición reconciliada queda como no demostrado. Estas reglas evitan que el dashboard muestre flexibilidad teórica mientras la operación real depende de intervención manual o supuestos no ensayados.
Capítulo 05
¿Cómo se evalúa la flexibilidad antes de una emergencia?
Ejecuta simulaciones mensuales y ejercicios integrados menos frecuentes con la utility. En el nivel uno, una orden firmada recorre el control plane sin cambiar potencia y produce un plan auditable. En el nivel dos, cargas sintéticas se reducen y recuperan con medición real. En el nivel tres, una ventana acordada activa el conjunto completo bajo supervisión. Compara tiempo de aviso, MW disponibles, velocidad de rampa, duración sostenida, pérdida de trabajo, latencia de producto, errores y tiempo de recuperación. Conserva el baseline climático y operativo: dos eventos con distinta temperatura exterior no prueban el mismo desempeño de cooling.
La telemetría eléctrica también tiene límites. El Departamento de Energía explica que cargas de IA sincronizadas pueden producir oscilaciones en varias frecuencias: los PMU son útiles para frecuencias bajas, mientras mediciones point-on-wave capturan dinámicas rápidas a costa de mucho más dato. No todo equipo necesita desplegar ambos sistemas, pero el diseño debe acordar con la utility qué resolución detecta la rampa prometida y qué señal revela comportamiento inseguro. Muestrear consumo cada cinco minutos puede servir para facturación y aun así ocultar un transitorio problemático de segundos.
Capítulo 06
Límites y riesgos que el contrato no elimina
La flexibilidad puede fallar por correlación. Una ola de calor eleva la demanda de la red y también el consumo de cooling del campus, reduciendo justo entonces los MW disponibles. Una actualización de modelo puede volver urgente un backlog antes considerado diferible. Un incidente de seguridad puede bloquear automatización o exigir conservar evidencia. Una batería puede estar reservada para continuidad, degradada o limitada por temperatura. Por eso la capacidad ofrecida debe calcularse con escenarios conjuntos y márgenes, no con el mejor día del trimestre. El contrato también necesita reglas para reducción parcial, indisponibilidad justificada y prioridades de seguridad.
Tampoco hay que convertir una proyección en ahorro realizado. Georgia Power proyecta beneficios futuros para clientes a partir de su portafolio de grandes cargas y crecimiento esperado; eso no demuestra todavía el ahorro de un hogar ni aísla el aporte de un solo proyecto. FERC, por su parte, mantiene procesos abiertos sobre transparencia, recuperación de costos y servicios para cargas flexibles. Un founder que compra capacidad debe revisar quién paga interconexión, upgrades, energía firme, penalidades y activos varados si el proyecto se retrasa o reduce. La arquitectura técnica y el acuerdo financiero son dos vistas del mismo riesgo.
Capítulo 07
La decisión: compra capacidad como un sistema operable
Si tu hoja de ruta exige infraestructura dedicada, pide la matriz de cargas, el mecanismo de reducción, la reserva de almacenamiento, la recuperación escalonada, la medición y la asignación de costos antes de firmar MW flexibles. Si operas en cloud público, aplica el mismo razonamiento a compromisos de capacidad, regiones y colas: identifica qué trabajo se desplaza, cuánto tarda y qué evidencia confirma que volvió sano. La escala cambia; la necesidad de un contrato entre energía, runtime y producto no.
Grid Protectors vuelve visible una frontera que la industria suele ocultar detrás del número de GPUs: el cómputo IA también es una carga física con efectos locales, tiempos de control y obligaciones financieras. La oportunidad no es llamar sostenible a una pausa ocasional. Es diseñar flexibilidad que pueda prometerse, ejecutarse, medirse y recuperarse sin sacrificar el servicio crítico. Si necesitas convertir una estrategia de capacidad en arquitectura, automatización y gates de aceptación, el servicio de agentes y desarrollo con IA a medida de Wasyra puede ayudarte a definir ese contrato operativo.
Escrito por
Wasyra Engineering
Modernización, arquitectura y delivery confiable
Wasyra Engineering documenta patrones para mover sistemas legacy sin congelar delivery ni romper ownership.
Serie
Sistemas IA que sí llegan a producción
Una serie sobre agentes, copilots y guardrails para llevar IA al trabajo real sin romper confianza ni operación.
Posts de esta serieMás de este autor
Más de este autor
Ingeniería
Inferencia en Kubernetes: valida el runtime completo
Un endpoint saludable no prueba la plataforma. Siete gates validan compatibilidad, scheduling, routing, observabilidad y rollback.
ArtículoIngeniería
Verificación formal con IA: siete gates para confiar en una prueba
Una prueba formal no vuelve infalible a todo el sistema. Siete gates separan una garantía verificable de una afirmación demasiado amplia.
ArtículoSigue leyendo
Sigue leyendo
Ingeniería
Inferencia en Kubernetes: valida el runtime completo
Un endpoint saludable no prueba la plataforma. Siete gates validan compatibilidad, scheduling, routing, observabilidad y rollback.
ArtículoIngeniería
Verificación formal con IA: siete gates para confiar en una prueba
Una prueba formal no vuelve infalible a todo el sistema. Siete gates separan una garantía verificable de una afirmación demasiado amplia.
ArtículoIngeniería
Migración legacy con IA: siete gates de paridad
Un benchmark alto no autoriza una migración legacy. Siete gates convierten traducción de código en evidencia de paridad y rollback.
Artículo